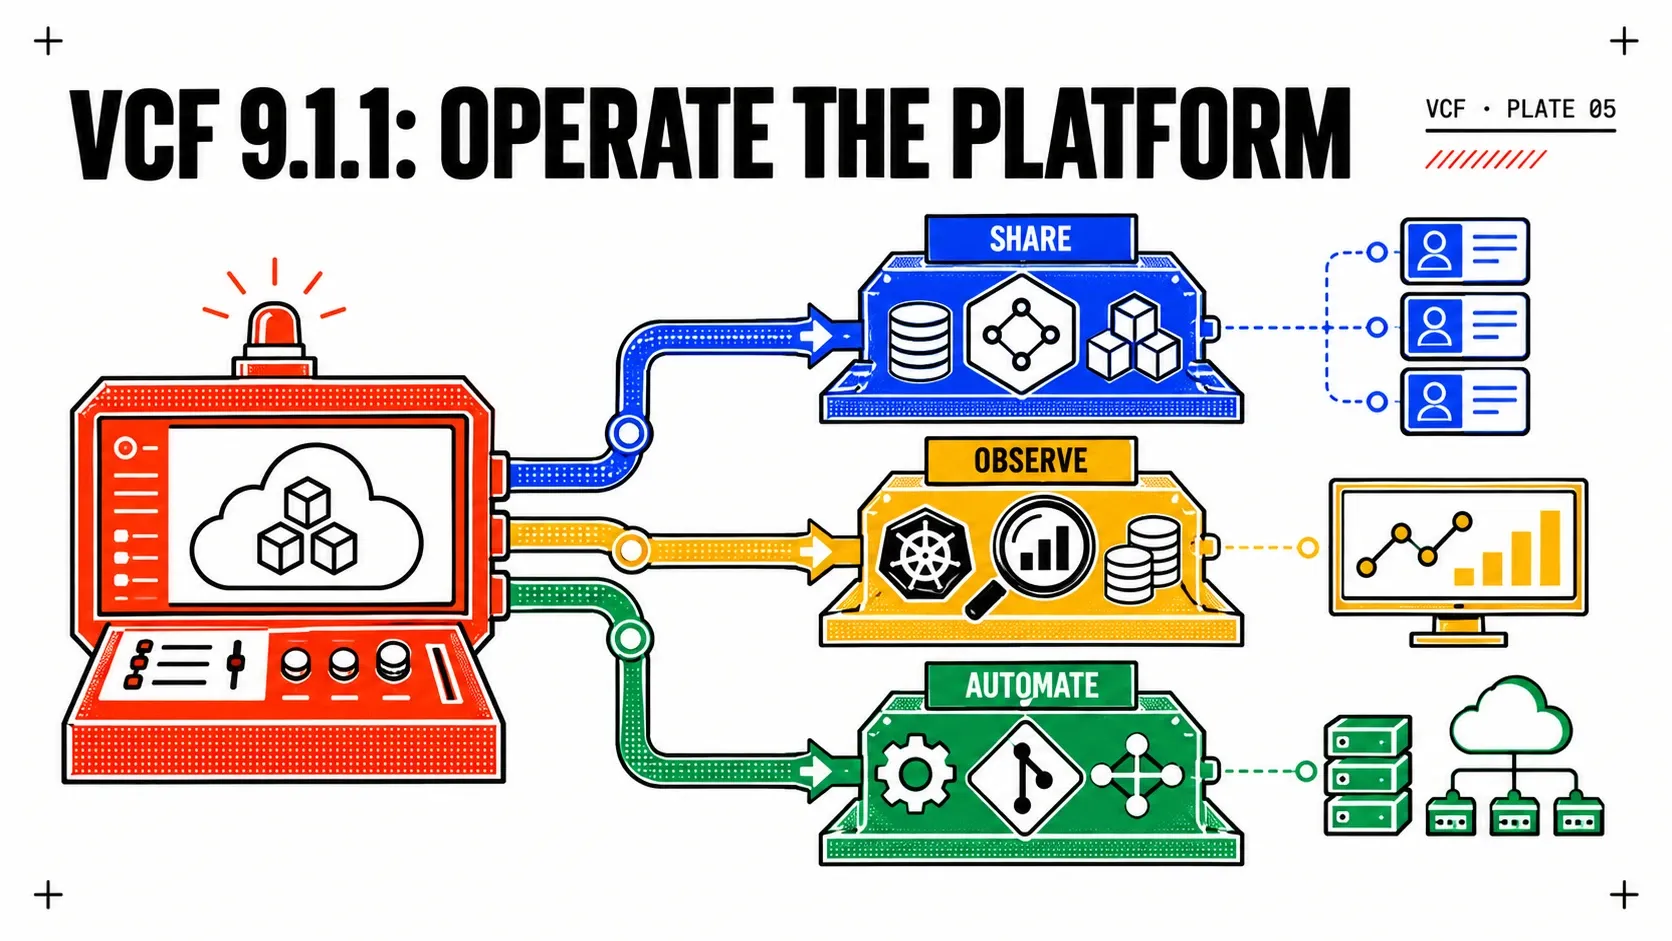
VCF 9.1 a changé les capacités de la plateforme. VCF 9.1.1 change la manière de les exploiter. Le numéro ressemble à celui d’une maintenance release, mais le périmètre opérationnel est bien plus large : modèles IA partagés, diagnostic conversationnel, télémétrie Kubernetes à deux secondes, GitOps natif, gestion étendue des identités et certificats, et chemin plus réaliste vers VCF 9.1.
La bonne question n’est donc pas « quelles lignes ont été ajoutées aux release notes ? », mais « quels changements justifient l’upgrade, lesquels modifient l’architecture et lesquels restent expérimentaux ? ». Cet article répond à cette question pour les architectes, les exploitants infrastructure et les équipes plateforme.
Un cinquième chapitre pour la série VCF 9.1
Cette mise à jour prolonge les quatre piliers initiaux de VCF 9.1 : efficience d’infrastructure, réseau, self-service Kubernetes et sécurité et résilience. C’est le chapitre Day 2 : intégration, observabilité, cycle de vie et problèmes qui n’apparaissent qu’une fois la plateforme en exploitation.
TL;DR
- Upgrade pour les opérations, pas pour une nouvelle headline hyperviseur. Les meilleurs arguments sont les chemins d’upgrade « back-in-time », les correctifs cumulatifs, la réduction de l’empreinte de management, l’observabilité VKS et la gestion de flotte étendue.
- Ne pas confondre présence et maturité production. Le partage multi-tenant des modèles et l’AI Assistant sont livrés ; le nouveau service GitOps de VCF Automation et vSAN Object Storage restent en Tech Preview.
- Action de lundi matin : inventorier les versions sources et les services activés, intégrer les prérequis de séquencement 9.1.1, puis valider l’upgrade sur un domaine de management représentatif avant d’exposer l’assistant IA ou GitOps aux utilisateurs.
Une maintenance release aux conséquences architecturales
VCF 9.1.1 est la première maintenance release de VCF 9.1. Elle cumule les correctifs et mises à jour de sécurité des Express Patches précédents, mais Broadcom s’en sert aussi pour retirer des freins à l’adoption. C’est important : un upgrade de cloud privé est rarement bloqué par la fonctionnalité phare. Il est bloqué par la version source, l’empreinte de management, la gestion des contenus hors ligne ou un état intermédiaire non supporté.
Le support des upgrades dits back-in-time est une évolution majeure. Des versions comme VCF 5.2.4, VCF 9.0.2 EP02 et plusieurs builds récents de vSphere 8.0 Update 3 étaient sortis après la baseline 9.1 initiale et ne disposaient pas du chemin direct attendu vers 9.1.0. VCF 9.1.1 rétablit des chemins supportés pour ces environnements. C’est moins spectaculaire qu’une démo IA, mais cela peut réellement débloquer un programme de migration.
Le VCF Download Tool devient également plus utile dans les environnements contrôlés ou déconnectés. La nouvelle option --latest filtre les binaires vers les derniers Express Patches applicables. Un workflow artifacts télécharge désormais les contenus OCI : mises à jour Supervisor, versions VKS, Supervisor Services, plugins VCF CLI, services VCF et mises à jour Data Services Manager. Une équipe plateforme peut donc choisir les versions Kubernetes approuvées au lieu de répliquer tout le catalogue dans son dépôt offline.
Attention cependant : 9.1.1 impose des exceptions de séquencement. Les pre-checks intégrés sont un garde-fou, pas un design d’upgrade.
| Avant de mettre à jour… | Mettre d’abord à jour… |
|---|---|
| Les autres composants VCF vers 9.1.1 | Fleet Lifecycle Management vers 9.1.1 |
| Identity Broker ou Salt Master/RaaS | VCF Management Services vers 9.1.1 |
| VCD Migrator | VCF Automation vers 9.1.1 |
C’est exactement le type de dépendance qu’une lecture « simple patch » fait oublier. Il faut figer la Bill of Materials cible, écrire l’ordre dans le plan de changement et conserver les preuves de rollback de chaque composant avant de démarrer.
Private AI devient partagé — et les opérations gagnent un copilote
La capacité GA la plus stratégique est le partage multi-tenant des modèles dans VCF Private AI Services. Un Model Runtime unique peut servir plusieurs tenants ou lignes métier tout en gardant leurs namespaces et données privées isolés. L’effet économique est direct : il n’est plus nécessaire de dupliquer modèle et capacité GPU coûteuse pour chaque équipe. L’effet de gouvernance est encore plus intéressant : le cycle de vie du modèle reste centralisé tandis que la consommation est déléguée.
Cela ne veut pas dire « un endpoint partagé pour tout le monde ». L’architecture doit toujours définir les frontières de tenancy, les quotas, les règles d’admission des modèles et les tests prouvant que prompts, données récupérées et sorties ne traversent pas les namespaces. L’infrastructure partagée réduit la duplication ; elle augmente l’importance des tests d’isolation. Cette approche s’inscrit dans les principes présentés dans Private AI sur VCF : architecture de référence.
VCF Operations reçoit aussi un AI Assistant for VCF optionnel. Il se configure localement avec un modèle fourni par Private AI Services ou avec une instance privée de Google Gemini. L’assistant répond à des questions opérationnelles en langage naturel, corrèle alertes de santé, configuration et logs, aide au diagnostic de vSphere et des services de management, et génère du contenu de management packs pour des intégrations tierces.
L’intérêt n’est pas qu’un LLM « pilote le cloud ». L’intérêt est la compression : passer plus vite de plusieurs alertes et erreurs vMotion à une hypothèse de diagnostic testable. Une adoption production exige malgré tout un modèle de confiance :
- définir quelles télémétries et configurations sont accessibles au modèle ;
- conserver les preuves originales à côté de chaque explication générée ;
- laisser la remédiation derrière une validation humaine ;
- évaluer l’assistant sur des incidents connus avant de l’utiliser sur un incident inconnu.
Un assistant qui produit une réponse plausible sans preuve traçable peut allonger le MTTR au lieu de le réduire. Il faut le traiter comme une interface de diagnostic, pas comme une autorité.
Les opérations Kubernetes passent du polling à la preuve
VCF 9.1.1 rend VKS beaucoup plus observable depuis le plan de contrôle infrastructure. VCF Operations corrèle les métriques compute, réseau et stockage avec les événements et logs Kubernetes. Le chemin temps réel documenté peut streamer les métriques toutes les deux secondes avec OpenTelemetry. Cela ferme un angle mort classique : un pod peut démarrer, saturer, échouer et disparaître entre deux collectes traditionnelles à cinq minutes.
Le monitoring multi-cluster s’appuie sur une collecte OpenTelemetry automatisée, et les dashboards Grafana existants peuvent être importés à côté des vues VKS natives. L’intérêt est organisationnel autant que technique : équipes plateforme et infrastructure examinent le même incident sans imposer à l’équipe applicative d’abandonner ses dashboards.
Le compromis est le volume. Une métrique à deux secondes n’est pas simplement « une métrique cinq minutes en mieux » : ingestion, rétention et cardinalité augmentent fortement. Il faut commencer par les signaux utiles aux incidents, définir plusieurs niveaux de rétention et mesurer le coût avant d’activer la haute fréquence sur tous les clusters. L’objectif est de conserver la preuve transitoire, pas chaque label pour toujours.
VKS 3.7 ajoute aussi un Add-on Management Framework. Sa promesse concrète : un cycle de vie et une responsabilité de support plus clairs pour les add-ons de réseau, observabilité, sécurité et stockage. L’add-on cesse d’être un YAML anonyme installé par un projet et devient une dépendance plateforme gérée avec un chemin de support déclaré.
Deux offres Argo CD différentes
Le service Argo CD Supervisor introduit précédemment reste supporté en production. Le nouveau service VCF Automation qui permet aux utilisateurs d’organisation de provisionner et rattacher des instances Argo CD depuis le portail Automation est en Tech Preview dans 9.1.1. Il ne faut pas transférer le statut production de l’opérateur sous-jacent à cette nouvelle intégration self-service.
La Tech Preview reste intéressante côté architecture. VCF Automation installe le service, intègre l’authentification OIDC, scope les opérateurs par région et rattache vSphere Namespaces et clusters VKS comme cibles de déploiement. Elle réduit la colle entre self-service infrastructure et livraison applicative. Il faut l’évaluer dans une organisation non-production avec des frontières d’identité et multi-régions réalistes, sans en faire encore l’unique chemin de livraison production.
Réseau, identité et certificats : les gains Day 2 discrets
L’interopérabilité EVPN reçoit davantage qu’un simple gain d’échelle. Des tunnels VXLAN directs entre les transit gateways VCF et les leaf switches physiques optimisent les flux Est-Ouest. NAT, NSX Load Balancing, Avi Load Balancing et DHCP relay deviennent disponibles dans le mode de connectivité distribuée EVPN VXLAN. Sur une fabric multi-tenant importante, moins de détours signifie des domaines de panne et un troubleshooting plus lisibles.
VCF 9.1.1 supporte aussi une distributed transit gateway adossée à un VLAN sans réseau TEP sur les hôtes. Cela abaisse le coût d’entrée d’un design VPC et reste compatible avec VKS et VCF Automation, mais ce n’est pas l’équivalent d’un overlay complet. Les private subnets, services SNAT/DNAT/VPN et protocoles non-IP comme VRRP ou multicast ne sont pas disponibles dans ce mode. Il convient aux connectivités simples et aux labs, pas au remplacement silencieux d’un design overlay.
Les opérations de sécurité deviennent plus dynamiques. L’appartenance aux groupes Active Directory et OpenLDAP peut être évaluée à la connexion au lieu de préprovisionner tous les utilisateurs. Les workflows de mots de passe couvrent davantage de comptes applicatifs et de management. Le cycle de vie des certificats s’étend aux NSX Edges, vSphere Supervisors, License Servers, cloud proxies et collecteurs réseau, avec suivi d’expiration, alertes d’échec de renouvellement, intégration de CA tierces et support de certificats non-TLS.
Enfin, les VMware Salt for VCF Component APIs exposent plus de 300 paramètres de configuration avec les constructs Salt. L’opportunité est un état désiré à l’échelle de la flotte. Le risque est un blast radius à l’échelle de la flotte. Il faut commencer en lecture seule, versionner les states, tester sur un domaine canari et séparer la détection de dérive de la correction automatique tant que la baseline n’est pas fiable.
Moins d’empreinte management, des labs plus accessibles
VCF Operations 9.1.1 introduit un format compact annoncé jusqu’à 40 % moins gourmand en CPU et mémoire, avec une configuration haute disponibilité à deux nœuds. VCF Management Services est redimensionné pour le Day 0, et la nouvelle option Small HA évite de choisir entre l’empreinte minimale et la disponibilité du plan de contrôle.
Un environnement 9.1 existant ne rétrécit pas automatiquement après l’upgrade. Son sizing actuel est conservé ; profiter de la nouvelle empreinte exige le processus de right-sizing post-upgrade documenté, une fois tous les composants VCF Management Services passés en 9.1.1. La capacité récupérée sur le papier n’existe pas dans le cluster tant que cette étape n’est pas planifiée et vérifiée.
L’installeur expose aussi des workflows auparavant réservés à l’API ou à des overrides : dépôt offline HTTP avec URL personnalisée, déploiement single-host et utilisation de NVMe non-HCL avec vSAN ESA. Ce sont de vraies améliorations pour les labs et PoC. Elles ne changent pas le support production : les disques production doivent toujours figurer dans le Broadcom Compatibility Guide et le design doit respecter le nombre minimal d’hôtes documenté.
Upgrader maintenant, évaluer ou attendre ?
| Situation | Recommandation |
|---|---|
| VCF 9.1 en production avec une fenêtre de maintenance normale | Planifier 9.1.1 après validation du séquencement et des correctifs cumulatifs ; les améliorations opérationnelles justifient le cycle. |
| Programme bloqué par une version source back-in-time | Réévaluer maintenant : 9.1.1 peut fournir le chemin supporté absent de 9.1.0. |
| Nouveau déploiement compact ou déconnecté | Préférer 9.1.1 pour Small HA, l’UI offline depot, les artifacts VCFDT et l’empreinte réduite. |
| Intérêt principal pour GitOps natif ou vSAN Object Storage | Évaluer en lab ; les deux restent en Tech Preview et ne doivent pas porter une dépendance production. |
| Projet AI Assistant | Piloter avec accès aux données contrôlé, actions validées par un humain et benchmark d’incidents connus. |
Une séquence d’adoption réaliste sur 90 jours
La manière la plus sûre de consommer 9.1.1 consiste à séparer l’upgrade de la plateforme de l’activation des nouveaux services. Tout regrouper dans la même fenêtre rend chaque incident ambigu : vient-il de la nouvelle version d’un composant, du nouveau chemin de télémétrie, de l’intégration du modèle ou d’une nouvelle politique d’exploitation ? Un plan progressif garde les preuves lisibles.
Jours 0 à 15 — définir l’enveloppe d’upgrade. Exporter la Bill of Materials actuelle, cartographier chaque version source, lister les services VCF optionnels et identifier les contraintes du dépôt offline. Exécuter les pre-checks officiels, puis ajouter des baselines fonctionnelles : authentification, expiration des certificats, santé VKS, vMotion, cycle de vie des workload domains et jobs de reprise. Elles deviennent les preuves avant/après. Valider l’ordre des composants et répéter les points de décision de rollback plutôt que de se contenter d’une déclaration globale.
Jours 15 à 35 — upgrader la plateforme sans rien activer. Patcher Fleet Lifecycle Management en premier, respecter les dépendances VCFMS et VCF Automation, puis observer l’environnement pendant au moins un cycle opérationnel normal. Vérifier les automatisations existantes, les flux d’identité, les intégrations de monitoring et les support bundles. Le right-sizing VCFMS doit rester un changement séparé, après démonstration de la stabilité.
Jours 35 à 60 — activer l’observabilité et les contrôles de flotte. Connecter un petit ensemble de clusters VKS représentatifs au chemin OpenTelemetry à deux secondes. Mesurer le volume ingéré, la cardinalité, la rétention et l’utilité réelle pour les opérateurs avant généralisation. Intégrer les workflows de certificats et mots de passe dans VCF Operations en mode observation. Pour les APIs Salt, comparer d’abord l’état désiré à la réalité avant toute correction.
Jours 60 à 90 — ouvrir les nouveaux services de consommation. Piloter le partage multi-tenant avec deux équipes dont les frontières de données sont faciles à tester. Évaluer l’AI Assistant sur un catalogue d’incidents résolus et exiger un retour vers les télémétries sources. Tester la Tech Preview GitOps dans une organisation non-production avec de vrais groupes OIDC et de vraies frontières de namespaces. Au jour 90, ne promouvoir que les capacités disposant à la fois de preuves techniques et d’un responsable opérationnel nommé.
Cette séquence privilégie volontairement l’apprentissage plutôt que la vitesse d’activation. Elle permet de répondre proprement à la question que posera tout comité de changement après un incident : « qu’est-ce qui a changé, et comment le sait-on ? »
Pièges & points de vigilance
Le numéro de version cache trois niveaux de maturité
VCF 9.1.1 est GA. Cela ne rend pas chaque capacité GA : le self-service GitOps de VCF Automation et vSAN Object Storage restent en Tech Preview. Les options single-host et disques non-HCL facilitent les labs, mais ne redéfinissent pas la matrice de support production. Le statut de chaque capacité doit apparaître dans la décision d’architecture, pas seulement la version de la plateforme.
Quatre autres pièges doivent figurer dans le runbook :
- Ordre d’upgrade : patcher Fleet LCM en premier, puis respecter les dépendances VCFMS et VCF Automation. Un health check générique au vert ne supprime pas ces contraintes.
- Frontières des données IA : hébergé localement ne signifie pas automatiquement least privilege. Examiner les flux de prompts, logs, configurations et données récupérées.
- Économie de la télémétrie : les métriques VKS à deux secondes exigent un budget de cardinalité et de rétention.
- Sizing post-upgrade : la réduction d’empreinte VCFMS est volontaire pour un déploiement 9.1 existant ; vérifier la marge avant et après right-sizing.
Conclusion
VCF 9.1.1 est avant tout la release qui rend l’architecture VCF 9.1 plus exploitable. Elle ouvre des chemins d’upgrade bloqués, donne aux équipes plateforme plus de contrôle sur les artifacts offline et les add-ons Kubernetes, rend visibles les problèmes VKS transitoires, élargit la gestion des identités et certificats, et transforme Private AI en service partagé plutôt qu’en collection de stacks de modèles isolées.
La release mérite d’être planifiée maintenant, mais pas consommée aveuglément. Il faut séparer GA et Tech Preview, conserver les preuves autour de l’AI Assistant, dimensionner le pipeline de télémétrie et traiter l’ordre exceptionnel des composants comme une partie du design. Le meilleur déploiement 9.1.1 n’est pas celui où tout est activé : c’est celui où la frontière production est explicite.
L’upgrade devient praticable
Chemins back-in-time, meilleur offline depot et empreinte management réduite simplifient l’adoption de 9.1.
Le signal Day 2 progresse
Diagnostic assisté, télémétrie VKS à deux secondes et workflows credentials/certificats réduisent les angles morts.
Les frontières restent critiques
Tech Preview, confiance IA, coût des métriques et ordre d’upgrade appartiennent à l’architecture, pas à l’improvisation.
Sources officielles et techniques
Reçois le prochain par email
Les nouveaux articles et séries, envoyés à leur publication. Aucun autre courrier.