TOP a enfin sa barbe à papa Licorne magique. La corne tient. Les commandes arrivent. La boutique tourne sur v2.
Il observe le résultat et murmure : « C’est bien. Mais ça manque peut-être de paillettes intergalactiques. »
La nouvelle version passe les tests. L’image se construit. Les nouveaux serveurs deviennent prêts. TOP fait une commande avec paillettes : succès. Puis un groupe commande trois portions. Le distributeur se bloque.
Tout était vert, sauf l’expérience de ces clients. Après la fabrication et le rolling update, nous allons limiter l’exposition d’une nouveauté, observer ce qu’elle fait réellement et décider de poursuivre ou d’arrêter.
Notre défaut est volontaire : dans le labo, une commande de trois portions ou plus avec paillettes renvoie une erreur. Cela permet de comprendre le raisonnement sans attendre une panne aléatoire.
Le problème qui n’apparaît pas à l’ouverture
- Une nouveauté prêteLes contrôles connus passent, pas toutes les situations possibles.
- Une exposition limitéeChoisir qui rencontre la nouvelle version.
- Une observation utileMesurer les commandes, par version et par usage.
- Une décisionPromouvoir, attendre ou arrêter, puis remettre Git en cohérence.
Le test initial vérifie une portion avec paillettes. Il ne vérifie pas les groupes. La readiness constate que le serveur peut recevoir du trafic ; elle ne parcourt pas toutes les combinaisons du menu.
Il ne faut ni supprimer ces contrôles, ni leur demander de prédire tous les usages. Nous allons compléter la chaîne avec une livraison progressive : une mise en service dont l’exposition et la progression sont pilotées.
TOP change donc sa question. « La machine démarre-t-elle ? » devient : « Qu’arrive-t-il aux commandes qui lui sont confiées ? »
Canary : commencer par un petit comptoir
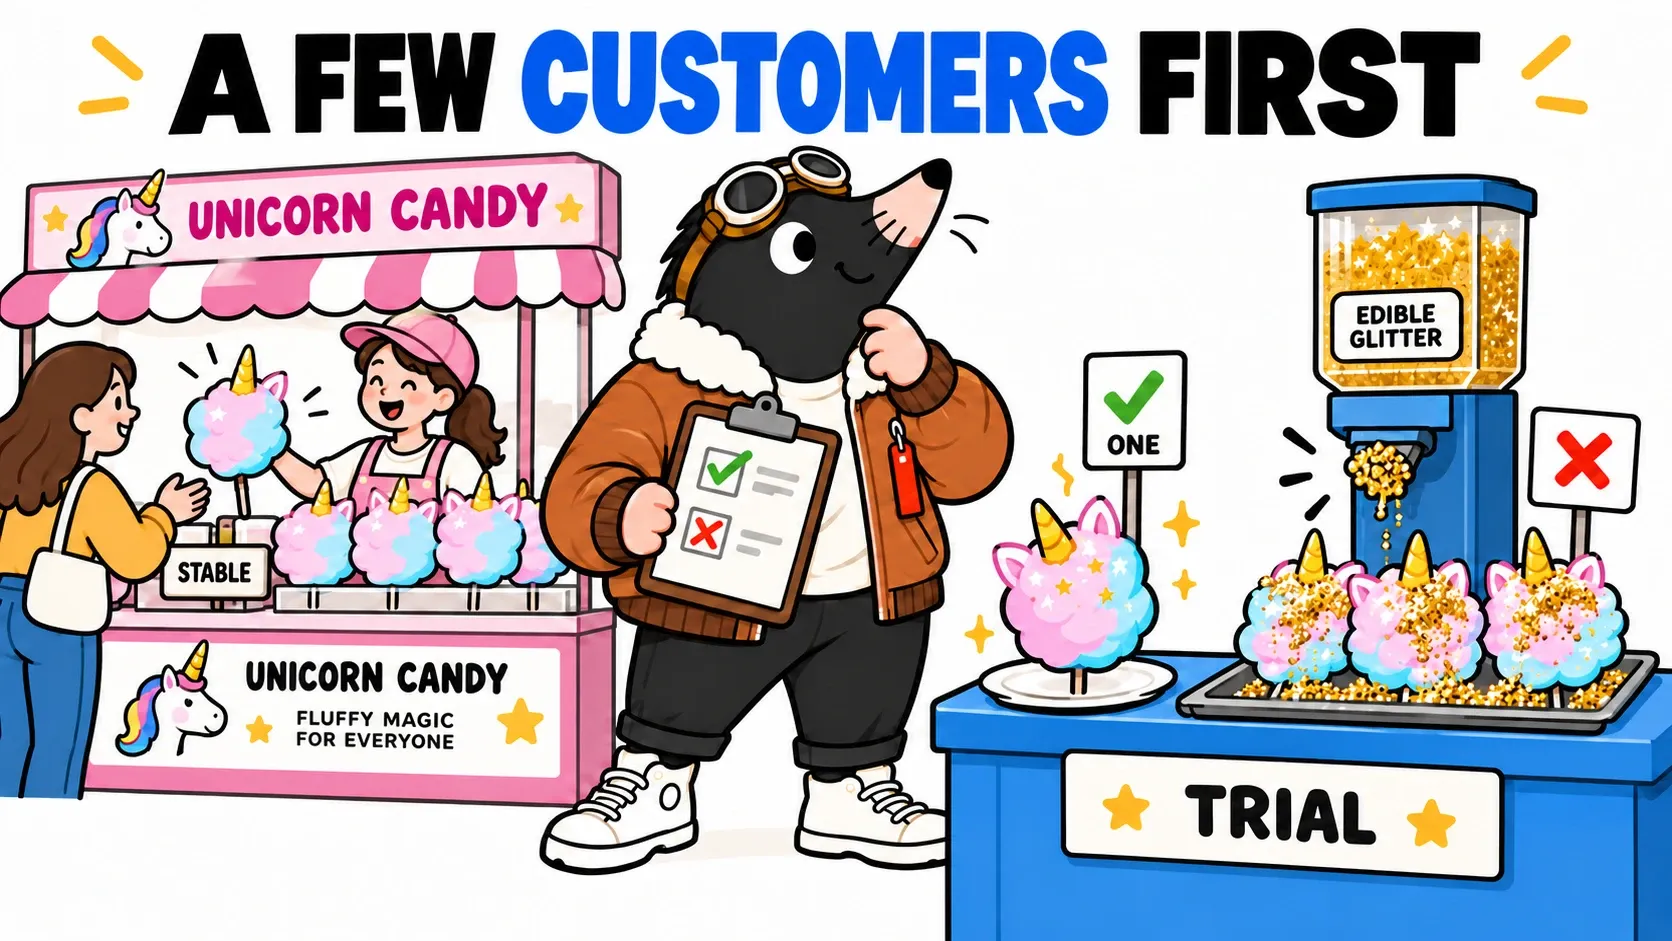
Pour un canary, TOP conserve les comptoirs stables et ouvre une petite capacité d’essai. Une partie du trafic atteint la nouvelle version. On observe avant d’augmenter son exposition.
Le nom ne désigne pas un test gustatif marketing. Le but ici est de limiter les conséquences d’un défaut et de recueillir des signaux techniques. Une expérience A/B cherche plutôt à comparer des variantes selon un objectif produit ; les mécanismes de routage peuvent se ressembler, mais les décisions ne sont pas identiques.
Sur Kubernetes, Argo Rollouts ajoute un contrôleur de livraison progressive et une ressource Rollout. Argo CD conserve son rôle de synchronisation depuis Git. Les deux outils se complètent : synchroniser une spécification n’est pas décider à quel rythme exposer une version. Architecture Argo Rollouts.
Notre exemple de base contient :
strategy:
  canary:
    steps:
      - setWeight: 10
      - pause: {}
      - setWeight: 50
      - pause: {}
Une pause vide attend une décision manuelle. Elle ne regarde aucune métrique toute seule. On commence par installer complètement la version stable ; ces étapes servent ensuite à une mise à jour, pas à créer une histoire de comparaison lors d’une première installation sans ancienne version. Étapes canary.
Dix pour cent de quoi ?
TOP pose un comptoir expérimental à côté de neuf comptoirs stables. « Donc exactement 10 % des clients ? »
Pas nécessairement. Sans routeur de trafic intégré, le canary de base s’approche du poids demandé par le nombre de réplicas. Les requêtes ne sont pas une file parfaitement régulière : connexions persistantes et répartition peuvent modifier ce que l’on observe. Pour piloter des poids de trafic, il faut une intégration compatible avec un Ingress, un service mesh ou un autre fournisseur pris en charge. Gestion du trafic.
Notre manifeste utilise dix réplicas et aucun routeur pondéré. Il sert à apprendre la progression et les pauses. Il ne promet pas exactement dix requêtes sur cent. Cette limite doit rester visible dans l’article, dans le labo et dans la manière de commenter ses résultats.
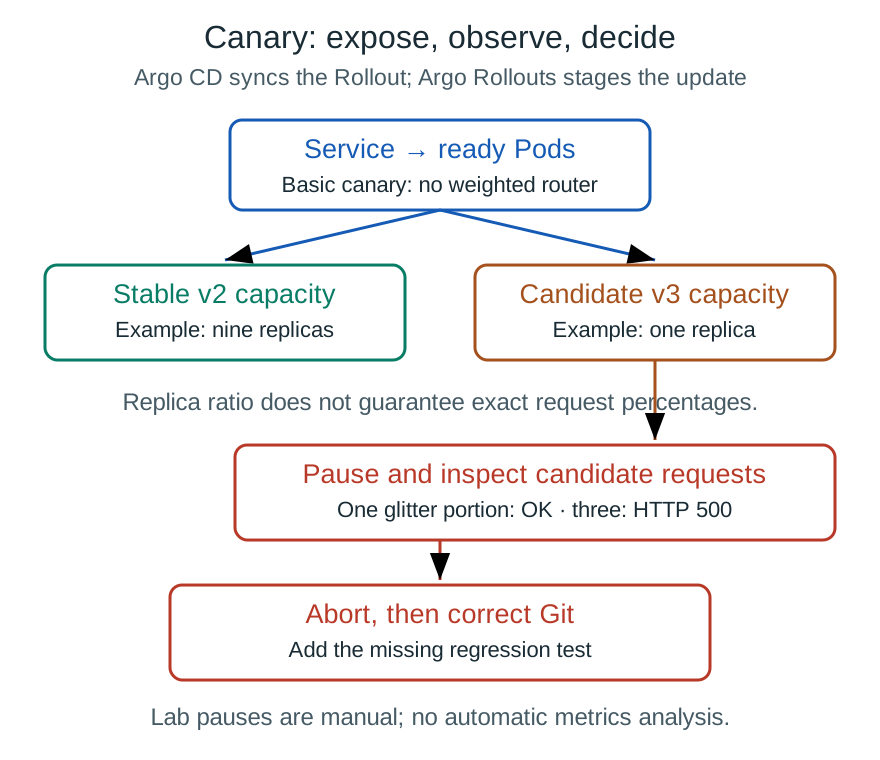
Le petit comptoir devient une capacité candidate. Observer ses erreurs avant de promouvoir ; le ratio de Pods ne garantit pas un pourcentage exact de requêtes.
Observer les commandes, pas seulement les voyants
Imaginons un relevé fictif : mille commandes, dont cent vers la nouvelle version. Vingt de ces cent commandes échouent. Le taux global est de 2 %, mais celui de la candidate atteint 20 %.
La moyenne de la boutique masque le problème du comptoir d’essai. TOP doit regarder la version, le type de commande et le volume observé. Dans notre histoire, l’indice décisif est la quantité : une portion réussit, trois portions bloquent le distributeur.
Avant d’exposer la nouveauté, nous écrivons une petite règle de décision :
| Observation | Décision pour notre exercice |
|---|---|
| Erreurs sur les commandes de groupe de la candidate | Arrêter l’essai et conserver la version stable |
| Trop peu de commandes pertinentes | Attendre ; ne pas conclure que tout fonctionne |
| Pas de métriques ou collecte en erreur | Suspendre la décision et vérifier la mesure |
| Parcours vérifiés, volume suffisant, pas de dégradation observée | Envisager le palier suivant |
Ces règles sont celles de notre démonstration. Un service réel doit définir son budget d’erreur, ses délais et ses critères métier. Il faut aussi mesurer la latence : une commande qui finit par répondre après une attente interminable n’est pas forcément acceptable.
Argo Rollouts peut exécuter des analyses à partir d’AnalysisTemplate et d’AnalysisRun. Un fournisseur de métriques fournit les observations ; des conditions déterminent le résultat. Dans notre labo, les pauses restent manuelles : nous n’avons pas configuré une analyse automatique. Analyses Argo Rollouts.
L’application expose des compteurs sur /metrics. Cela ne suffit pas à installer Prometheus, configurer la collecte ou définir une bonne requête. Un compteur sans observateur est un carnet que personne ne lit. Pour aller plus loin sur ces signaux, retrouve les fondations de l’observabilité.
Un nouveau parfum doit aussi trouver le bon comptoir
v2 ne propose pas encore les paillettes. Lui envoyer une commande avec ce supplément peut légitimement produire HTTP 400. Ce résultat ne doit pas être confondu avec le HTTP 500 de v3 sur une commande qu’elle prétend accepter.
Pour une comparaison technique, on observe des parcours communs aux versions. Pour la nouveauté, on teste explicitement la candidate et on organise son exposition : routage adapté ou activation séparée après compatibilité. Le simple canary par nombre de Pods ne règle pas ce contrat de menu.
TOP ne va donc pas afficher « paillettes pour tout le monde » avant de savoir où ces commandes atterriront. L’illustration du petit comptoir aide à voir cette frontière, mais le vrai logiciel a besoin d’une règle explicite.
Blue-green : préparer une deuxième boutique
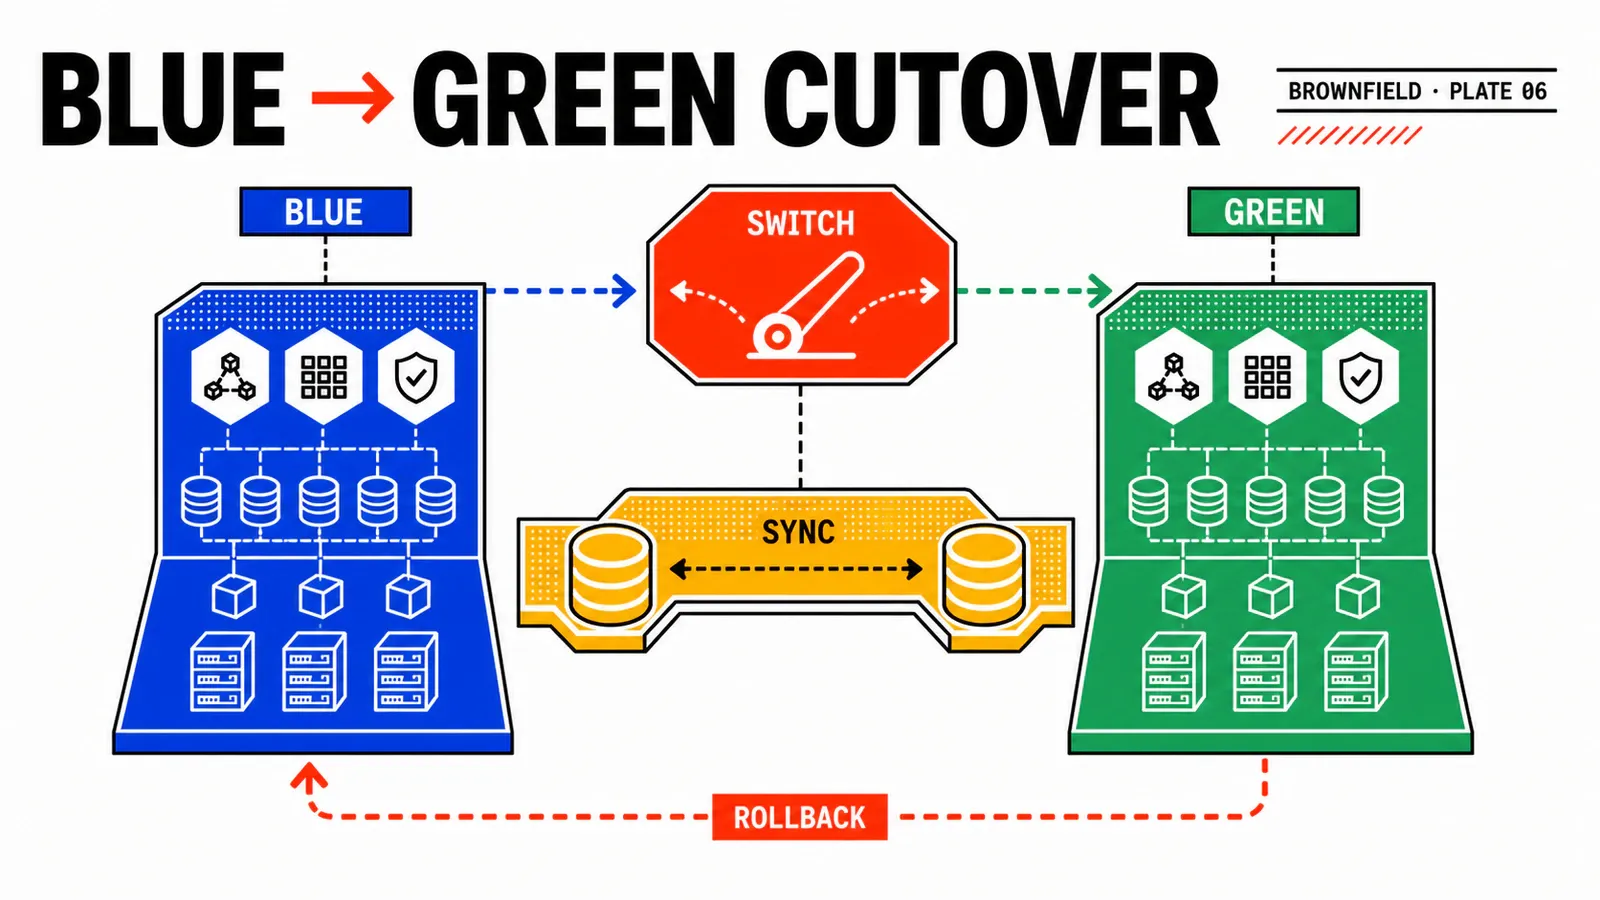
Une autre possibilité consiste à préparer un ensemble complet de nouveaux comptoirs. La boutique active sert les clients pendant que la candidate dispose d’un accès de prévisualisation. Après vérification, on bascule le service actif vers elle.
Avec Argo Rollouts, le modèle blue-green utilise un activeService et un previewService. Notre exemple met autoPromotionEnabled: false pour attendre une décision. Après promotion, un délai précède la réduction de l’ancien ensemble afin de laisser le routage se propager. Blue-green avec Argo Rollouts.
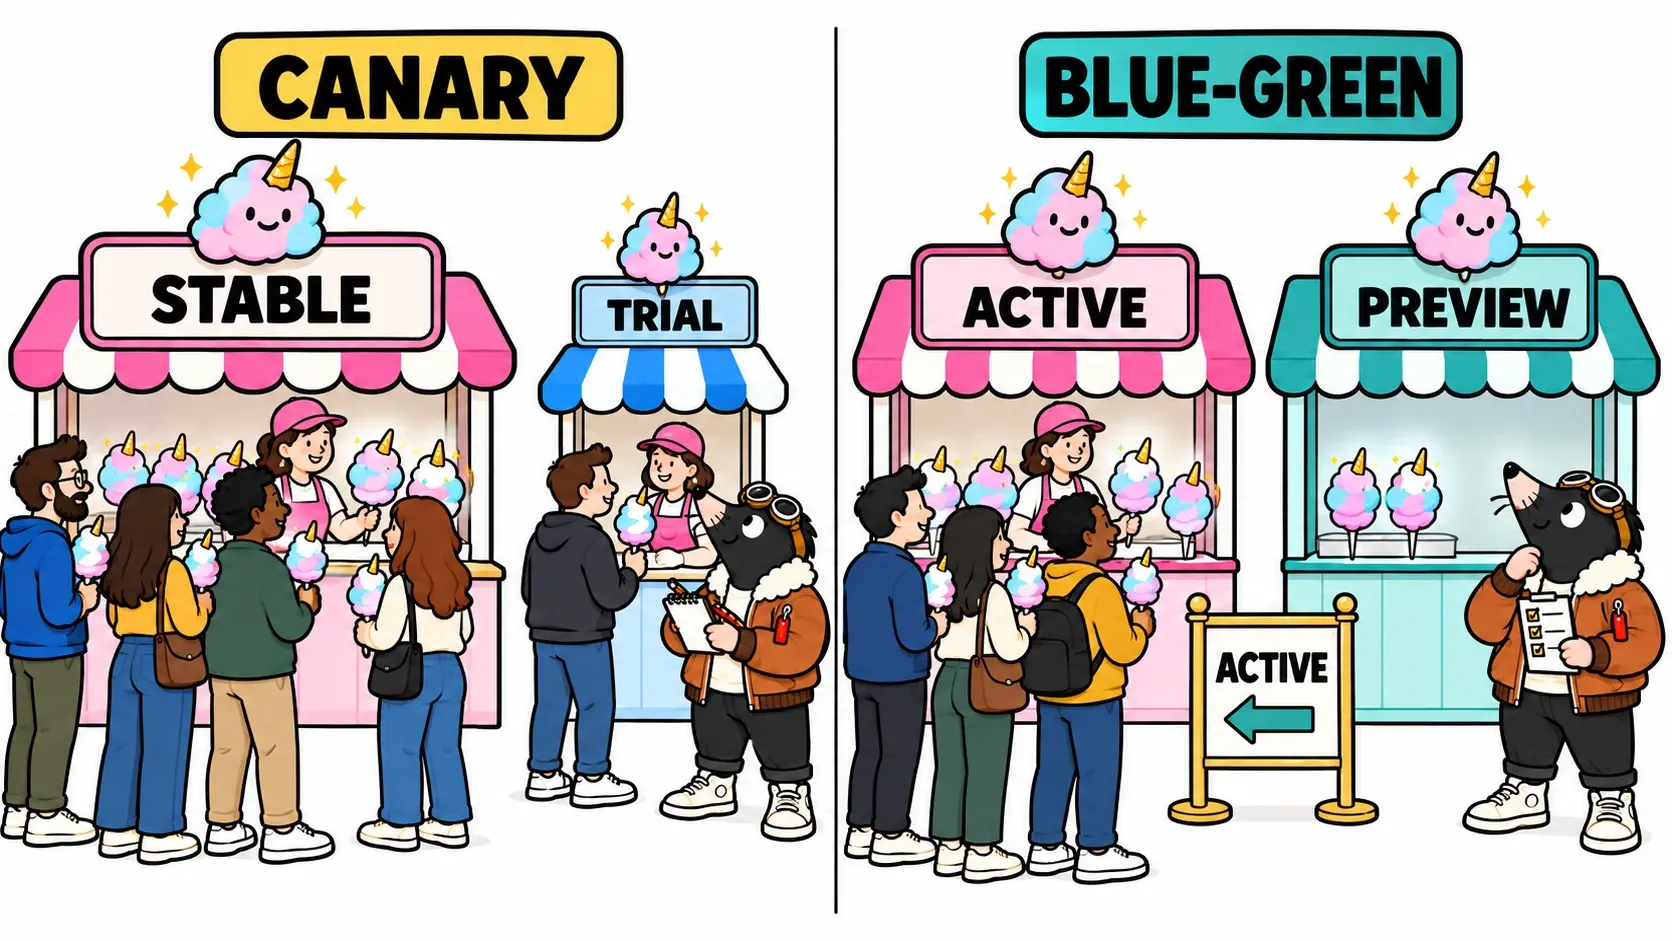
TOP apprécie de pouvoir visiter la boutique candidate avant d’y diriger les clients. Mais il faut pouvoir héberger les deux ensembles, et le basculement expose beaucoup de trafic à la fois. Garder l’ancien logiciel disponible facilite un retour ; cela n’annule pas les opérations déjà effectuées dans une base ou chez un prestataire de paiement.
| Approche | Ce qu’on organise | Point de vigilance |
|---|---|---|
| Rolling update | Le remplacement progressif des exemplaires | Compatibilité pendant la coexistence |
| Canary | Une exposition progressive de la candidate | Routage et qualité des observations |
| Blue-green | La préparation puis la bascule entre deux ensembles | Capacité, connexions et données partagées |
Il n’y a pas de podium universel. Pour notre petit service, la question utile est celle que l’équipe peut effectivement vérifier : sait-elle observer un canary ? Dispose-t-elle de la capacité de doubler l’environnement ? Peut-elle revenir sans casser les données ?
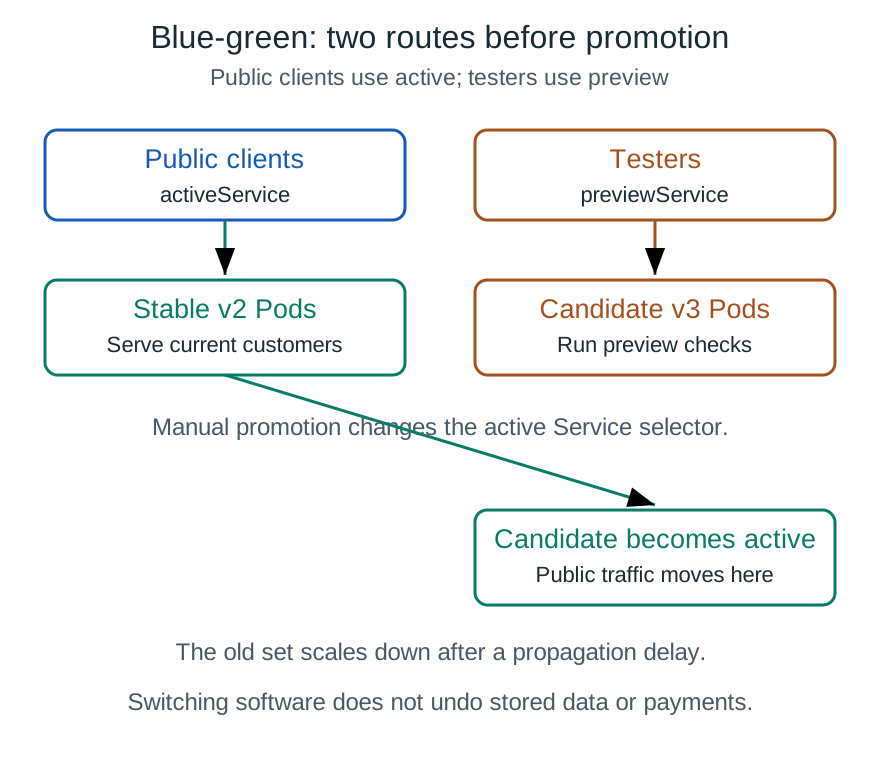
Deux accès distincts : les clients utilisent activeService, les essais utilisent previewService. La promotion change la destination active.
Arrêter l’essai, puis corriger le plan
Les commandes de groupe échouent. TOP n’attend pas le palier suivant. Il arrête la progression et laisse le service stable prendre le relais.
kubectl argo rollouts abort candy-canary -n candy-labAbort ne modifie pas le dépôt Git. Argo Rollouts gère l’état de la livraison ; nous devons ensuite annuler dans Git le changement vers l’image défectueuse, ou livrer sa correction selon la procédure choisie. Les conséquences exactes sur le trafic dépendent de la stratégie et de son intégration. Argo Rollouts et GitOps.
TOP retourne au laboratoire avec un exemple précis : trois portions et des paillettes. Il ajoute un test de non-régression qui échoue avec la version défectueuse, corrige le défaut, puis refait le trajet de CI. Le canary enrichit donc les prochains contrôles ; il ne devient pas une excuse pour livrer sans tests.
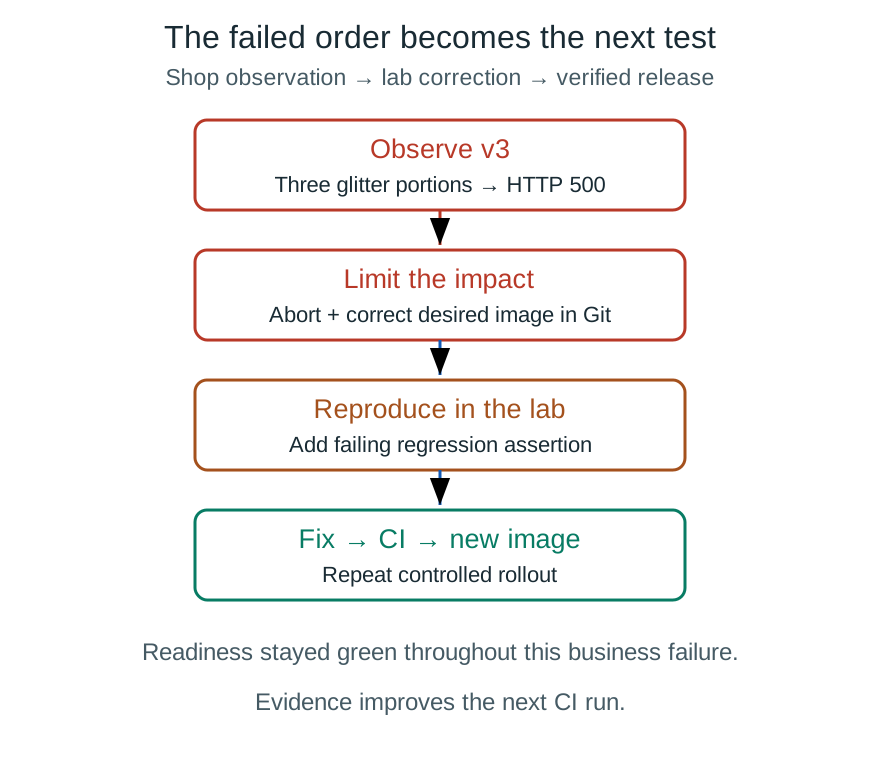
Le chemin de retour compte aussi : arrêter, corriger Git, reproduire le défaut et ajouter le test manquant.
À toi de coincer le distributeur
Le labo commun aux trois épisodes permet d’abord une reproduction locale. Arrête l’ancien serveur, puis exécute :
bun run scenario v3-bug
bun run test
bun run build
bun run start
Les tests initiaux et la construction passent. Dans un deuxième terminal :
bun run observe http://localhost:8080 --glitterLe script alterne une et trois portions sur vingt commandes. Tu dois observer dix succès et dix HTTP 500, tandis que /readyz reste à 200. Le défaut est injecté explicitement dans order.mjs pour l’exercice. Il ne s’agit pas d’un canary simulé : toutes ces requêtes ciblent la même instance locale.
Ajoute ce cas dans checks.mjs, après le contrôle de la commande individuelle et dans le bloc où les paillettes sont activées :
assert.equal(
  quote(catalog, { flavour: 'unicorn', quantity: 3, glitter: true }).status,
  200
);
Le test doit maintenant échouer avec v3-bug. Arrête le serveur, passe à bun run scenario v3-fixed, relance tests, build et serveur. La même boucle doit réussir vingt fois. Nous avons transformé une observation en protection contre la répétition du défaut.
Pour suivre les paliers sur VKS
Le dépôt GitOps contient deux exemples indépendants, canary/ et bluegreen/. Il faut installer un contrôleur Argo Rollouts compatible, ses CRD et son plugin, puis créer une Application Argo CD pour le chemin choisi. Ce sont des prérequis de plateforme, distincts du code de la boutique. Installation Argo Rollouts.
Déploie d’abord une image v2 complète, puis propose le digest de v3 dans Git. Observe la pause et les Pods. Pour le canary de base, utilise une vraie route de Service ; un port-forward ne démontre pas une répartition. Le README précise comment interpréter les réponses de l’ancienne version et comment arrêter la progression.
Pour blue-green, inspecte le Service de prévisualisation pendant que le Service actif continue de viser l’ancienne version. Ne promeus la candidate qu’après ses contrôles. Ces exemples n’installent ni routeur pondéré ni analyse Prometheus : ils rendent les choix visibles avant de les automatiser.
TOP referme son carnet. La recette a un prix correct. La corne rentre dans la machine. Les comptoirs attendent d’être prêts. Les commandes de groupe ont leur test.
Les paillettes peuvent attendre quelques minutes. Une bonne boutique préfère un client servi à un joli voyant vert.
Reçois le prochain par email
Les nouveaux articles et séries, envoyés à leur publication. Aucun autre courrier.