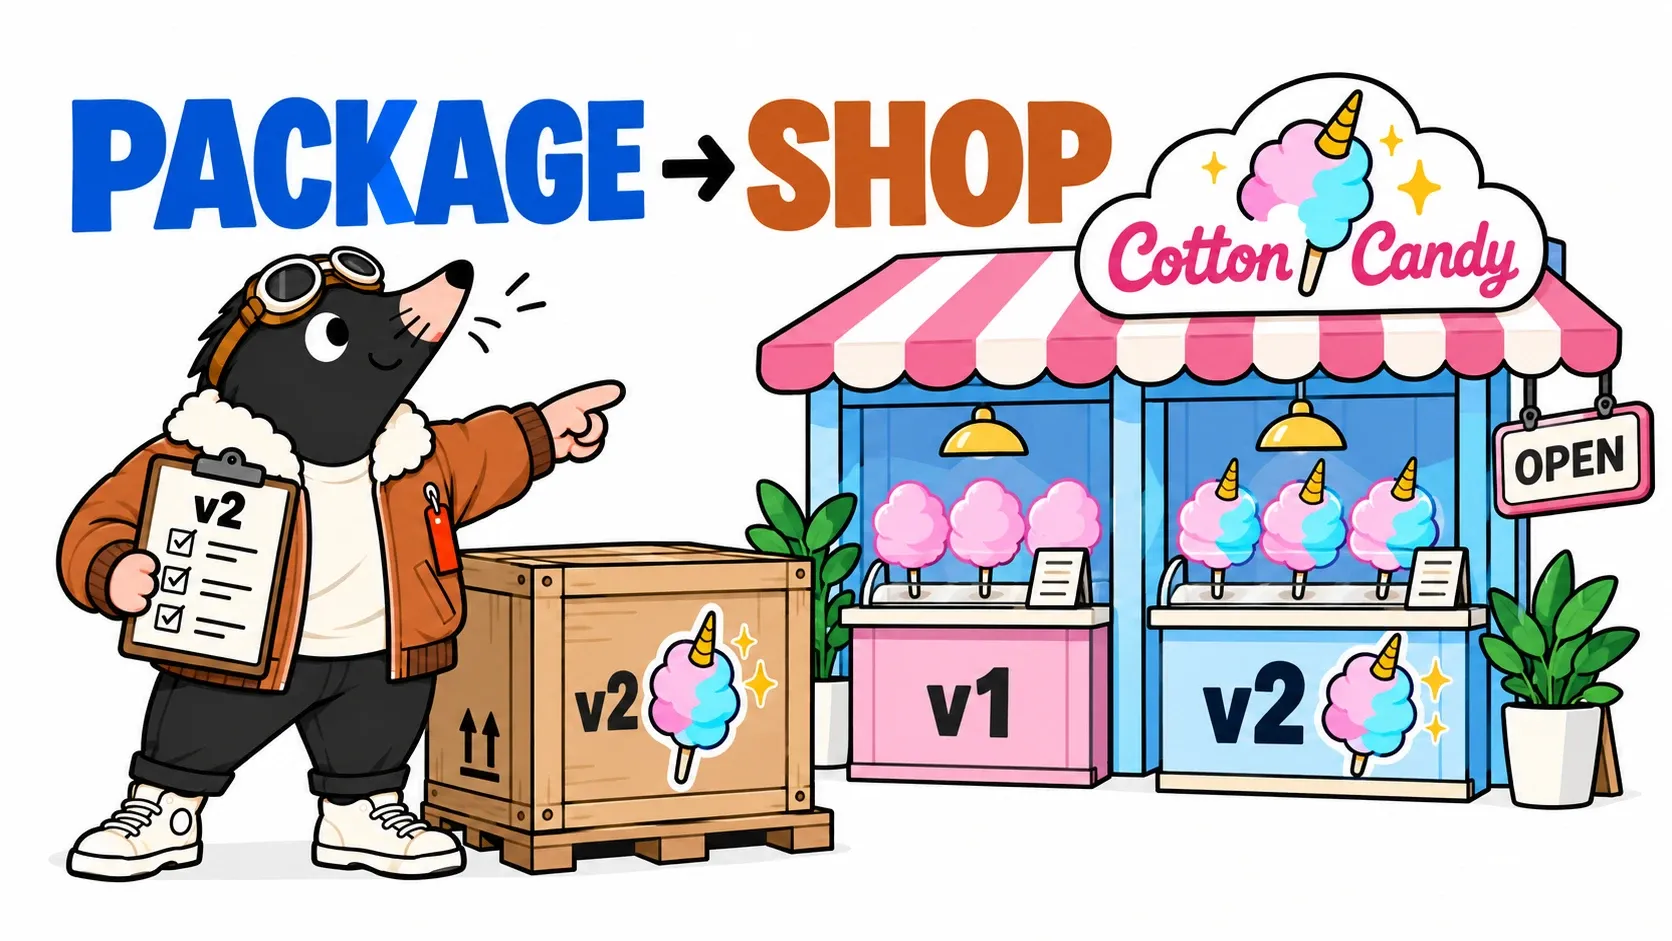
TOP pousse la porte du magasin, fier comme une taupe qui vient d’inventer une licorne. La recette est validée. La corne passe dans l’usine. Le carton v2 attend dans l’entrepôt.
Il commande Licorne magique. Le comptoir lui répond : « On a fraise. »
Dans le premier épisode, GitHub Actions a construit et publié une image de notre application. Publier cette image n’a pas modifié le service en fonctionnement. Il manque une instruction : quelle version faut-il exécuter, à quel endroit, avec quelle configuration ?
Nous allons écrire cette instruction dans Git, suivre Argo CD jusqu’à un cluster VKS et remplacer progressivement les exemplaires de l’application. Avec un détour : TOP voudra ouvrir un comptoir dont la lumière est allumée, mais qui n’est pas prêt à servir.
Le bon carton, à la bonne adresse
- L’entrepôtChoisir l’image déjà fabriquée et identifiée.
- Le plan de livraisonDécrire dans Git ce que le magasin doit utiliser.
- Les comptoirsRemplacer les exemplaires sans retirer trop tôt les anciens.
- La commandeVérifier le résultat du point de vue du client.
Notre boutique reste une analogie. L’application du labo renvoie un menu et calcule un devis en JSON. Un comptoir représente un exemplaire du serveur, pas un serveur physique ni un cluster entier. Plusieurs comptoirs peuvent connaître le même menu.
Le registre conserve l’image. Le dépôt du code conserve les sources. Un dépôt de déploiement séparé conserve notre plan de livraison. Cette séparation permet de lire une demande très simple : « dans cet environnement, remplacer l’image D1 par l’image D2 ». D1 et D2 sont ici des noms courts pour les vrais digests enregistrés à la fin du premier épisode.
Le même paquet peut être essayé dans un environnement de validation, puis utilisé en production avec une configuration adaptée. Le reconstruire pour chaque destination compliquerait la preuve : serait-ce encore le contenu vérifié ? Nous conservons donc l’image et changeons explicitement la configuration autour d’elle.
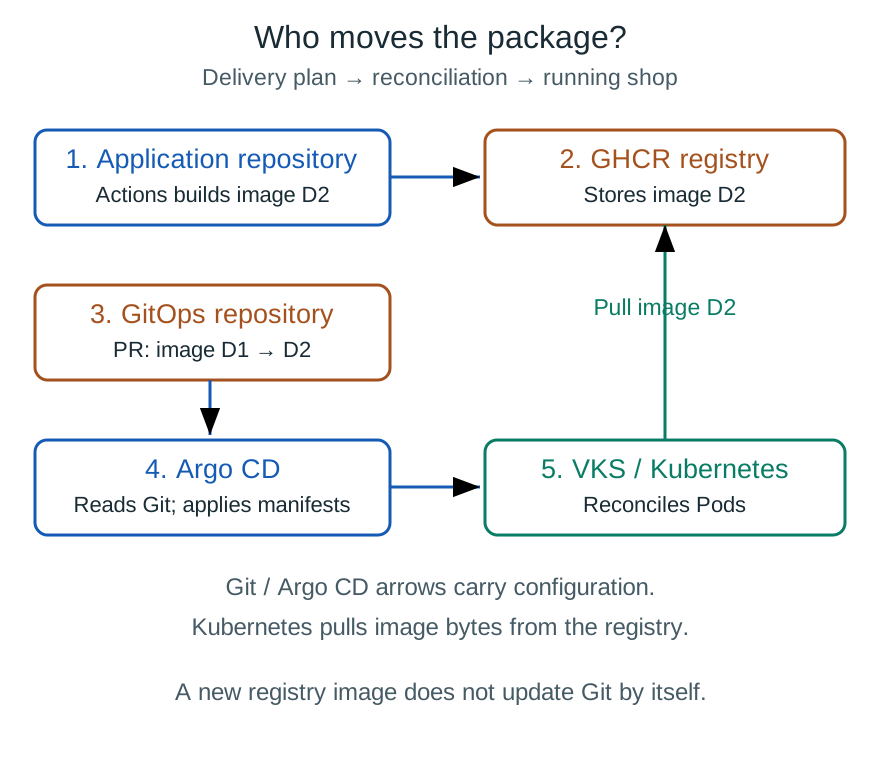
Le trajet technique du colis : Actions fabrique, GHCR conserve, Git décrit, Argo CD synchronise et Kubernetes récupère l’image.
Le carnet de livraison devient un état souhaité
Lire le trajet sans confondre le plan et le colis
Dans le schéma précédent, suis deux objets différents. Le plan est un petit fichier YAML : il voyage de Git vers l’API Kubernetes par Argo CD. Le colis est l’image : lorsqu’un Pod doit démarrer, le nœud Kubernetes la récupère dans GHCR. Argo CD ne transporte pas les fichiers de l’application dans les Pods.
TOP aurait pu envoyer une photo du carton au magasin. Cela ne lui aurait livré ni le carton, ni la consigne de l’ouvrir. En informatique aussi, chaque passage a son propre contrat : un accès en lecture au dépôt pour le plan, des droits sur le cluster pour l’appliquer et un accès au registre pour récupérer l’image.
Cette distinction aide au diagnostic. Git est inaccessible ? Argo CD ne peut pas lire le plan. Une référence d’image est incorrecte ou son téléchargement est refusé ? Le Pod ne peut pas préparer son conteneur. Le conteneur démarre mais refuse les commandes ? Nous avons encore changé d’étape. Une seule flèche « déployer » masquerait ces trois problèmes.
TOP note : « Trois comptoirs, application v2. » Dans Kubernetes, nous utilisons un Deployment pour décrire ces exemplaires et leur remplacement. Son modèle de Pod indique l’image et ses paramètres. Le Pod est l’unité qui héberge notre conteneur applicatif.
Le dépôt du labo contient aussi un Service : une adresse stable qui sélectionne les Pods de l’application. Les Pods peuvent être recréés avec d’autres adresses ; les clients continuent de viser le Service. Services Kubernetes.
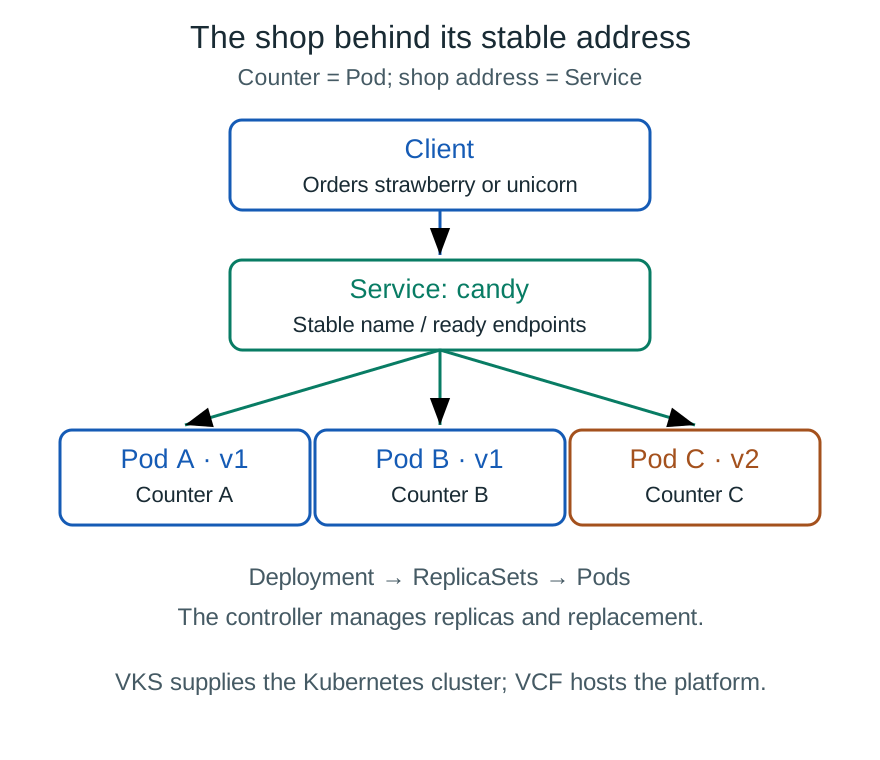
Un comptoir est un Pod. Le Service donne une adresse stable ; le Deployment organise les exemplaires.
Pour proposer v2, TOP ouvre une PR modifiant la référence d’image :
Avant : ghcr.io/mon-equipe/la-barbe-a-top@sha256:D1
Après : ghcr.io/mon-equipe/la-barbe-a-top@sha256:D2
Ces lignes expliquent la différence ; D1 et D2 ne sont pas des digests valides à copier. Dans les fichiers du labo, remplace le marqueur par la référence complète réellement publiée. Le nom de registre est également celui de ton dépôt, pas une image publique préexistante.
La PR rend la destination et le paquet lisibles. La configuration non sensible peut vivre à côté ; les valeurs des secrets restent dans un mécanisme dédié. Un mot de passe encodé en base64 dans Git reste un mot de passe exposé. Gestion des Secrets Kubernetes.
TOP a maintenant écrit l’état souhaité. Le magasin utilise encore v1 : c’est l’état réel. La différence entre les deux devient quelque chose que l’on peut observer.
Pour relier les noms du schéma au fichier : replicas: 3 demande trois exemplaires, image: choisit leur paquet, et les labels permettent au Service de retrouver les bons Pods. Le Deployment pilote des ReplicaSets, qui maintiennent ces exemplaires. Lors d’une modification du modèle de Pod, un nouveau ReplicaSet apparaît pour la nouvelle version. Le Service peut donc sélectionner des Pods des deux versions durant la transition. Fonctionnement des Deployments.
Argo CD lit le plan ; Kubernetes fait tourner la boutique
Argo CD surveille le dépôt configuré et compare les manifests au cluster cible. Une différence apparaît comme OutOfSync. La synchronisation applique la configuration ; elle peut être manuelle ou automatique. Le modèle du labo active l’automatisation et selfHeal, qui permet aussi de corriger des écarts introduits dans le cluster. La suppression automatique de ressources est laissée désactivée. Synchronisation automatique Argo CD.
Le partage des rôles tient en une phrase :
GitHub Actions fabrique ; le registre conserve ; Git décrit la destination ; Argo CD synchronise ; Kubernetes exécute.
C’est notre première expérience de GitOps : la configuration attendue est déclarée, versionnée et réconciliée avec l’environnement. Argo CD ne vient pas compiler la recette dans le cluster. Il demande l’exécution de l’image déjà produite. Principes OpenGitOps.
Imagine que TOP efface à la main un comptoir alors que le plan en demande trois. Le contrôleur Kubernetes cherche à retrouver le nombre demandé. Si TOP modifie directement une configuration gérée par Argo CD, selfHeal peut remettre celle décrite dans Git. Réconcilier, c’est répéter cette comparaison et corriger l’écart ; ce n’est pas lancer une livraison une seule fois puis oublier la boutique.
Sur VKS, ce mécanisme reste celui de Kubernetes. VCF fournit le contexte d’infrastructure, VKS le cluster, et Argo CD cible ce cluster. Notre application ne dialogue pas avec VCF à chaque commande de barbe à papa. Pour un cluster VKS distinct de celui où Argo CD tourne, il faut l’enregistrer comme destination et autoriser ce périmètre dans le projet Argo CD.
Ouvrir le nouveau comptoir avant de fermer l’ancien
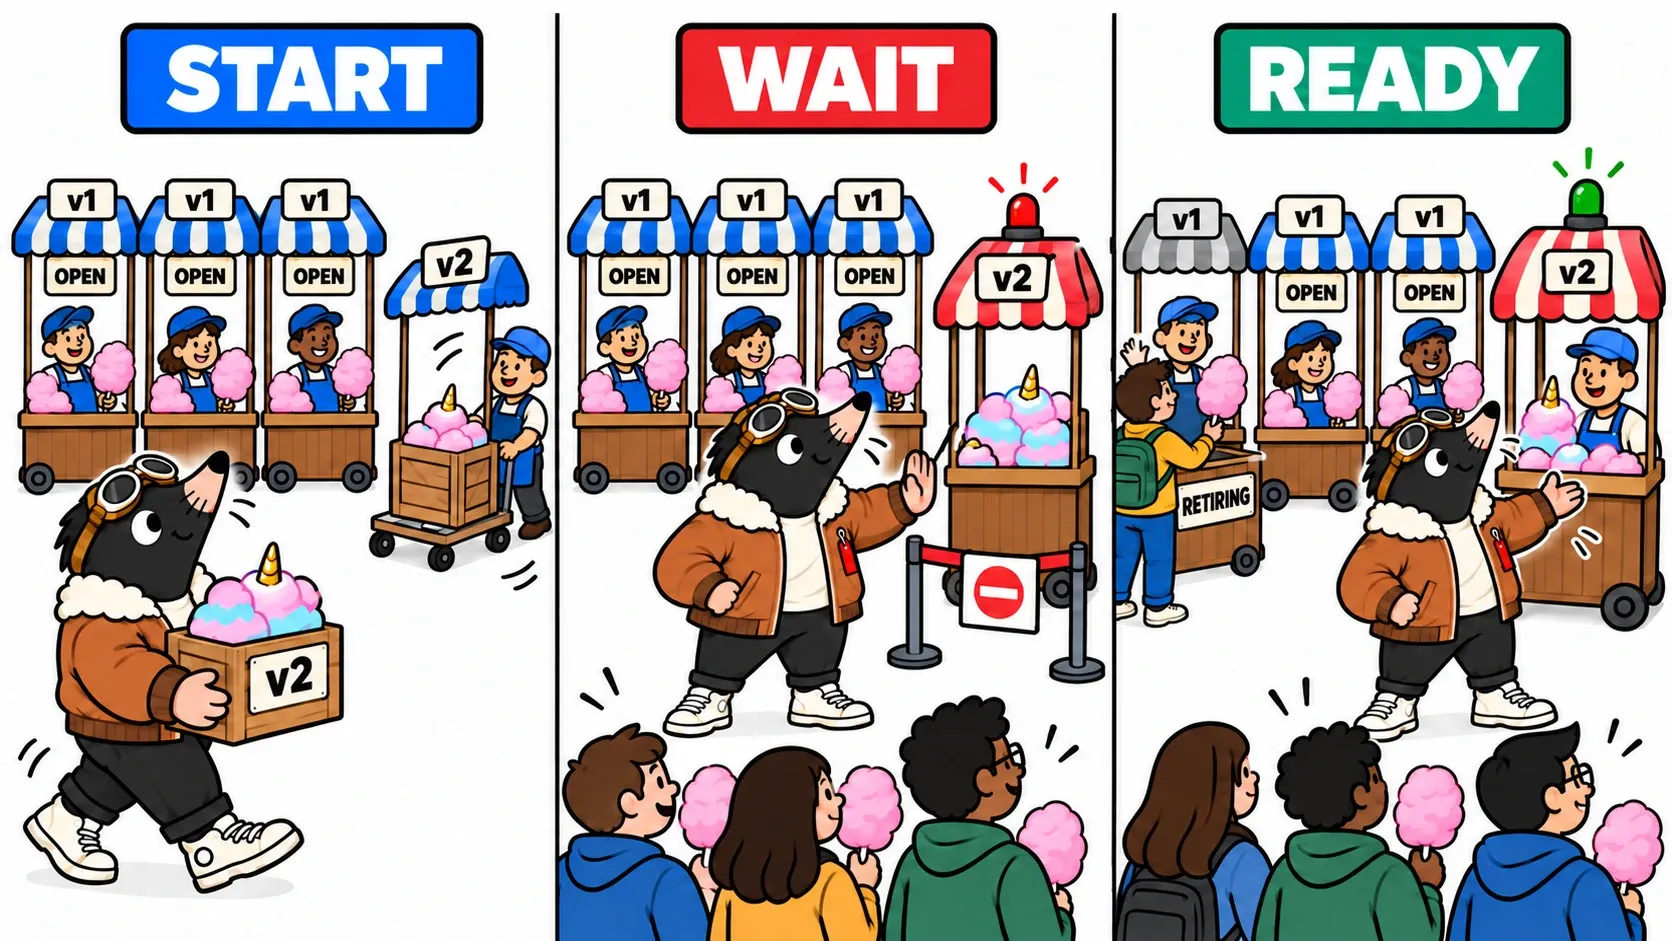
TOP refuse de fermer toute la boutique pour accrocher un menu. Nous avons trois comptoirs. Il en prépare un quatrième, attend qu’il puisse servir, puis retire progressivement les anciens.
C’est le principe du rolling update : faire cohabiter temporairement ancienne et nouvelle versions pendant le remplacement. La progression ne doit pas être confondue avec un pourcentage de trafic garanti vers chacune. Mise à jour progressive Kubernetes.
Notre Deployment contient ces valeurs :
replicas: 3
minReadySeconds: 5
progressDeadlineSeconds: 120
strategy:
  type: RollingUpdate
  rollingUpdate:
    maxSurge: 1
    maxUnavailable: 0
maxSurge: 1 autorise un exemplaire supplémentaire pendant la progression. maxUnavailable: 0 demande de préserver le nombre d’exemplaires disponibles. minReadySeconds: 5 impose une courte stabilité avant de compter le nouveau Pod comme disponible. Des Pods en terminaison peuvent encore consommer des ressources : « trois plus un » n’est pas un plafond absolu de consommation instantanée. Paramètres du Deployment.
Ces valeurs sont celles de notre labo. Si le cluster ne peut pas accueillir le nouveau Pod, le déploiement peut attendre. La petite boutique doit réellement avoir la place d’installer son comptoir supplémentaire. Et une panne indépendante peut toujours rendre les anciens indisponibles.
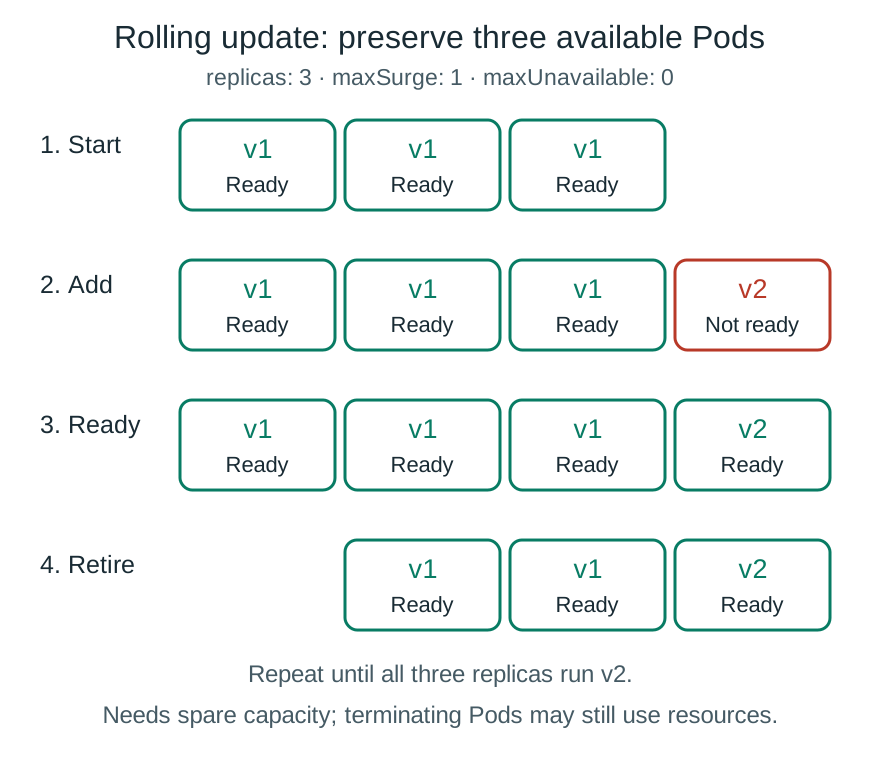
Trois Pods disponibles : ajouter v2, attendre sa readiness, puis retirer v1. Répéter le cycle.
La lampe est allumée. Le comptoir est-il prêt ?
TOP voit un processus démarré et s’apprête à envoyer des clients. Le comptoir n’a pourtant pas encore ses sachets.
Une readiness probe teste la capacité déclarée de l’application à recevoir du trafic. Dans le labo, Kubernetes appelle /readyz. Une réponse d’échec retire le Pod des destinations prêtes du Service ; elle ne signifie pas, à elle seule, « redémarrer ce conteneur ». Une sonde de vie et une sonde de démarrage répondent à d’autres besoins. Sondes Kubernetes.
Pour provoquer le raté, nous ajoutons dans Git une variable FORCE_NOT_READY=1. Le serveur fonctionne : sa page répond. Sa readiness renvoie pourtant HTTP 503. Le nouveau comptoir reste fermé et la progression se bloque.
progressDeadlineSeconds permet de signaler ce manque de progression. Un Deployment ne revient pas automatiquement en arrière parce que ce délai expire. TOP doit comprendre le problème et corriger le plan. Dans notre cas, une PR annule l’ajout de la variable. Le comportement attendu et les commandes d’observation sont détaillés dans le README du labo.
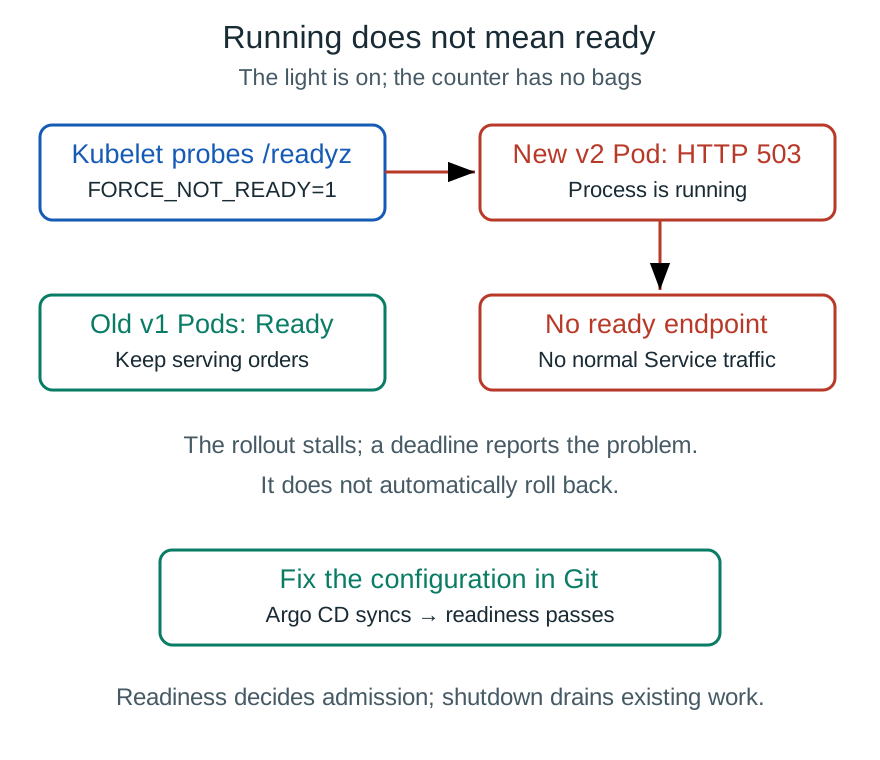
Le Pod v2 démarre mais sa readiness échoue : les anciens servent, le remplacement attend une correction dans Git.
Laisser le dernier client terminer
Le schéma de readiness montre une porte d’entrée. L’arrêt gracieux gère la sortie : on cesse d’accueillir de nouvelles commandes, puis on laisse finir celles déjà prises. Ce sont deux moments différents. Un Pod sorti des destinations prêtes peut encore avoir une connexion ou une requête en cours.
Le nouvel exemplaire est prêt. Peut-on débrancher brutalement l’ancien ? TOP regarde une barbe à papa à moitié emballée. Réponse : non.
Lors de la terminaison, il faut laisser le routage évoluer et l’application finir les requêtes en cours. Notre serveur reçoit SIGTERM, annonce qu’il n’est plus prêt, attend cinq secondes, puis ferme son écoute en laissant les connexions se terminer. Le Pod dispose de trente secondes de grâce ; au-delà, l’arrêt peut devenir forcé. Ce sont des valeurs de démonstration à mesurer selon l’application. Terminaison des Pods.
Une longue requête, un téléchargement ou une connexion persistante mérite son propre essai. L’image d’un comptoir que l’on ferme explique le geste ; elle ne garantit pas que tous les protocoles réagiront de la même façon.
Le piège du menu pendant la cohabitation
TOP annonce immédiatement Licorne magique à tout le monde. Une commande atteint v2 : succès. La suivante arrive sur v1 : parfum inconnu.
Les deux serveurs sont disponibles. Le problème est la compatibilité fonctionnelle pendant leur coexistence. Le client a pu lire le nouveau menu sur v2 avant d’envoyer sa commande à v1.
Dans un vrai service, on peut déployer d’abord la prise en charge du nouveau format, puis activer sa présentation une fois tous les serveurs compatibles. Cela sépare déploiement du code et activation de la fonctionnalité. Une base de données demande la même prudence : ajouter un champ compatible avant d’en supprimer un ancien, par exemple.
Notre labo sans stockage permet de voir le problème sans migration. Il ne démontre ni la conservation des commandes ni le retour arrière d’une base. La transparence pour le client dépend de ces contrats autant que des paramètres Kubernetes.
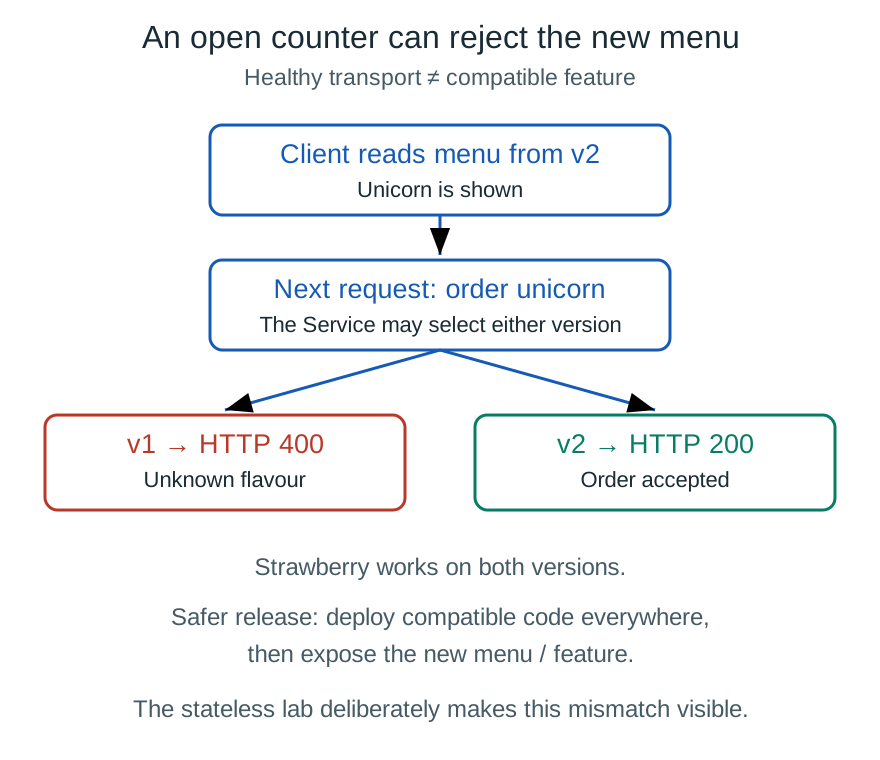
Lire le menu sur v2 puis commander sur v1 peut échouer. Disponible ne veut pas dire compatible avec la nouveauté.
Trois preuves, et un labo pour les observer
TOP tient trois tickets, au lieu d’un seul tampon vert :
| Question | Preuve recherchée |
|---|---|
| Le plan a-t-il été appliqué ? | L’état de synchronisation Argo CD |
| Les ressources semblent-elles fonctionner ? | La santé des ressources et les Pods prêts |
| Le client obtient-il le service ? | Une vraie requête, sa version et son résultat |
Argo CD distingue synchronisation et santé. Un statut Healthy repose sur des évaluations des ressources ; il ne remplace pas nos contrôles métier. Santé des ressources Argo CD.
Le labo sur GitHub fournit l’application ; le dépôt GitOps contient le Deployment, le Service et l’Application Argo CD. Pour le parcours complet, il faut un cluster de labo, Argo CD installé, l’accès à Git et au registre, ainsi qu’un chemin réseau vers le service. Nous partons d’un VKS existant. VKS permet de gérer des clusters Kubernetes dans VCF ; nous ne provisionnons pas ici la plateforme. Présentation de VKS.
Publie d’abord l’image v1, puis v2 avec les scénarios du premier épisode. Crée un fork du dépôt GitOps et clone-le pour travailler sur ton propre plan de déploiement. Renseigne les vrais digests et l’URL Git. Le modèle cible le cluster local d’Argo CD : pour un VKS distant, adapte la destination enregistrée et le projet autorisé.
git clone https://github.com/doudidas/la-barbe-a-top-gitops.git
cd la-barbe-a-top-gitops
Cette commande consulte le dépôt original. Pour modifier et pousser tes essais, remplace doudidas par ton compte après avoir créé ton fork. Fais aussi pointer repoURL dans application.yaml vers ce fork.
Après installation de v1, une PR remplace D1 par D2. Observe :
kubectl -n candy-lab get pods -w
kubectl -n candy-lab rollout status deployment/candy --timeout=180s
Pour suivre les requêtes pendant la transition, utilise l’adresse réellement desservie par le Service, via ton Ingress/Gateway, ou un client dans le cluster. kubectl port-forward service/candy sélectionne un Pod : c’est utile pour l’inspecter, mais cela ne démontre pas l’équilibrage ni la continuité du rolling update. Limites du port-forward.
Le script observe.mjs enchaîne des commandes et affiche version, instance et statut. Pour tester la continuité entre v1 et v2, utilise le parfum commun strawberry comme indiqué dans le README. Teste ensuite Licorne magique et explique les refus de v1. Termine en provoquant l’échec de readiness, puis en annulant le commit responsable dans Git.
Pour revenir à une image précédente, le même principe s’applique : corriger la référence souhaitée dans Git. Un changement manuel isolé dans le cluster risque d’être corrigé à son tour par la réconciliation. On veut que le plan reste cohérent avec le service rétabli.
TOP savoure enfin sa Licorne magique. Il regarde la corne, puis le pot posé à côté.
« Et si on ajoutait des paillettes intergalactiques ? »
Dans le troisième épisode, les tests passeront et les comptoirs ouvriront. Pourtant, certaines commandes échoueront. Nous apprendrons à exposer une nouveauté progressivement, à observer les vrais clients et à arrêter avant d’aggraver le problème.
Reçois le prochain par email
Les nouveaux articles et séries, envoyés à leur publication. Aucun autre courrier.