
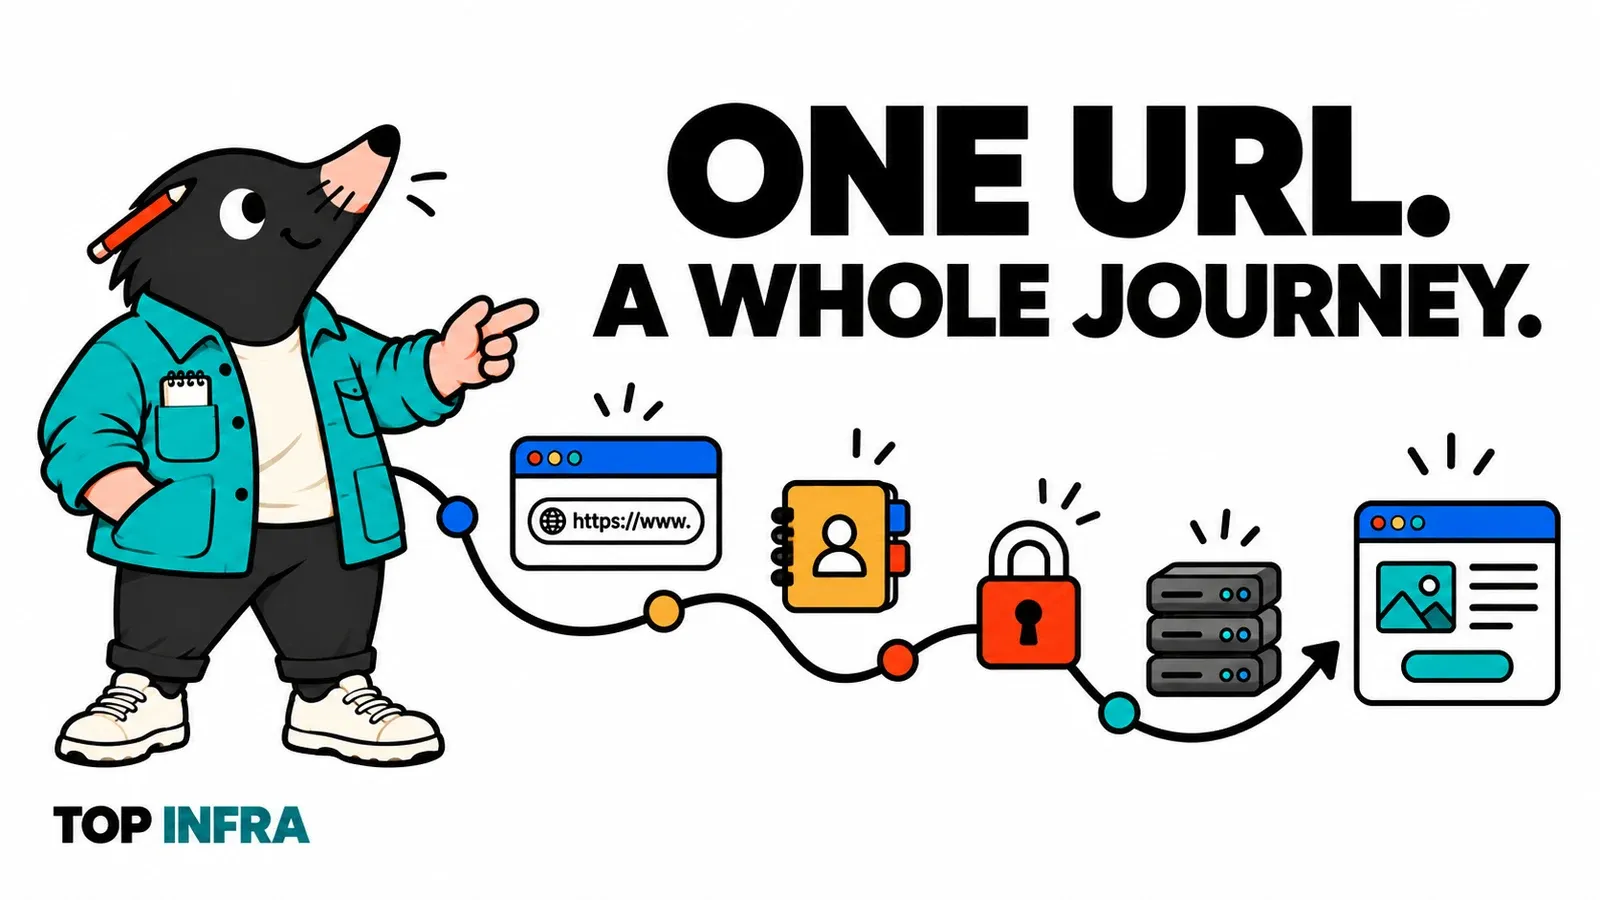
Tu tapes une adresse, tu appuies sur Entrée et une page apparaît. Entre les deux, ton navigateur a trouvé un interlocuteur, établi une connexion, demandé du contenu et commencé à l’afficher. Tout cela paraît instantané… jusqu’au jour où une étape ne répond plus.
Bienvenue dans TOP creuse l’infra, l’infrastructure expliquée aux développeurs. Pour ce premier épisode, aucune machine à installer : on suit une navigation et on apprend à reconnaître ses étapes. Pas besoin de connaître le modèle OSI pour embarquer.
Notre trajet en un coup d’œil
Voici les grandes questions que le navigateur doit résoudre. Ce sont des étapes logiques, pas six machines alignées sur Internet.
- URLQu’est-ce que je demande ?
- DNSÀ quelle adresse me connecter ?
- ConnexionComment joindre le service ?
- TLSAvec qui échanger en sécurité ?
- HTTPQuelle réponse à ma demande ?
- AffichageComment construire la page ?
Pour démarrer, imaginons une première visite en HTTPS, sans connexion déjà ouverte ni réponse utilisable en cache. Dans la réalité, le navigateur peut réutiliser du travail déjà fait. On reviendra sur ce raccourci.
Lire l’adresse avant de partir
Notre exemple fictif est https://boutique.example/produits/?tri=prix#details. Il sert à expliquer le trajet ; ce n’est pas une boutique à ouvrir.
httpsindique le protocole utilisé pour accéder à la ressource.boutique.exampleest le nom de l’hôte./produits/est le chemin demandé.?tri=prixtransmet un paramètre à l’application.#detailsdésigne un fragment traité côté navigateur ; il n’est pas envoyé dans la requête HTTP.
Le port n’apparaît pas : HTTPS utilise ici son port par défaut, 443. Le chemin ne correspond pas forcément à un dossier sur un disque. Une application peut décider quelle réponse produire pour cette adresse. Repère : anatomie d’une URL, MDN.
Cette séparation donne déjà une bonne habitude : avant de chercher une panne réseau, vérifier le nom et le chemin. Une lettre oubliée dans le premier et une faute dans le second peuvent produire des échecs très différents.
Trouver une adresse, puis joindre un service
Le navigateur a un nom ; il lui faut une adresse IP. La résolution DNS permet notamment de retrouver les adresses associées à cet hôte. Un résolveur cherche la réponse, éventuellement en interrogeant d’autres serveurs DNS. Les caches peuvent éviter de refaire toute la recherche. Repère : fonctionnement du DNS, Cloudflare.
Le navigateur doit ensuite joindre un service à cette adresse. Pense au port comme à un numéro de point d’entrée : connaître le bâtiment ne suffit pas, il faut encore qu’un service écoute à la bonne porte. Un pare-feu peut également laisser passer ou bloquer la communication.
Pour HTTP/1.1 ou HTTP/2 en HTTPS, la connexion utilise TCP, puis TLS protège les échanges. HTTP/3 utilise QUIC sur UDP, avec TLS intégré à l’établissement de la connexion. Le trajet logique reste utile, mais « tout le Web passe par TCP » serait faux. Repère : HTTP/3, MDN.
À ce stade, retiens trois questions distinctes : le nom est-il résolu, la destination est-elle joignable, le service accepte-t-il la connexion ? Elles évitent de ranger tous les problèmes dans un vague « Internet ne marche pas ».
Établir la confiance avec HTTPS
Avec HTTPS, le navigateur vérifie notamment que le certificat présenté est valable pour le nom demandé et qu’il peut lui faire confiance. TLS protège la confidentialité et l’intégrité des échanges sur cette connexion. Repère : TLS, MDN.
Cela ne certifie ni l’honnêteté du commerçant ni l’absence de bugs dans l’application. Le navigateur vérifie une connexion sécurisée vers un nom, pas la qualité du service qui répond.
Pour notre visite, cette nuance suffit. On n’a pas besoin de détailler les algorithmes cryptographiques : l’idée utile est de savoir où la connexion protégée commence et où elle se termine. Dans un futur épisode, on pourra suivre un certificat de plus près.
Demander une ressource et recevoir une réponse
La conversation applicative utilise maintenant HTTP. Dans notre exemple, le navigateur demande les produits triés par prix. Une représentation simplifiée en HTTP/1.1 ressemble à ceci :
GET /produits/?tri=prix HTTP/1.1
Host: boutique.example
HTTP/2 et HTTP/3 codent cette conversation autrement ; les notions de méthode, de ressource et de réponse restent. La réponse apporte un statut, des en-têtes et, lorsqu’il y en a un, un corps. Repère : vue d’ensemble de HTTP, MDN.
Qui prépare cette réponse ? Pour une page statique, un serveur peut simplement renvoyer un fichier. Pour une page dynamique, l’application peut calculer un résultat ou consulter des données. Un intermédiaire peut aussi répondre sans solliciter l’application.
Le cache est justement un raccourci : une réponse conservée peut être réutilisée selon ses règles de fraîcheur, ou revalidée. Il peut exister dans le navigateur et dans une infrastructure partagée, comme un CDN. Recharger une page ne signifie donc pas forcément refaire le même travail côté serveur. Repère : cache HTTP, MDN.
Pour raisonner, imagine deux visites à notre boutique. La première réclame une image du produit ; la seconde peut retrouver cette image en cache. Le résultat visible ressemble au premier, mais le trajet et le coût peuvent changer. C’est aussi pour cela qu’une capture isolée ne raconte pas toutes les visites.
Construire la page, puis observer ce qui s’est passé
Recevoir du HTML ne termine pas le travail. Le navigateur l’analyse, découvre des ressources comme les feuilles de style et les images, et construit progressivement l’affichage. Du JavaScript peut encore déclencher des requêtes. Une page correspond souvent à plusieurs échanges, qui peuvent se chevaucher. Repère : fonctionnement du navigateur, MDN.
Une page peut ainsi commencer à s’afficher alors qu’une image manque encore. Ou afficher une coquille correctement, puis échouer à charger les produits. « La page s’ouvre » et « toutes ses fonctionnalités marchent » sont deux observations différentes.
Dans Chrome ou un navigateur Chromium :
- Sélectionne la requête du document HTML. Regarde son URL et son statut.
- Ouvre Timing. Repère les phases de connexion et l’attente de la réponse lorsqu’elles sont présentes.
- Choisis ensuite une image, par exemple TOP. Compare sa requête à celle du document.
- Recharge encore. Certaines ressources peuvent venir du cache ; certaines connexions peuvent être réutilisées.
Les libellés dépendent du navigateur. Une phase DNS ou TLS absente ne signifie pas qu’Internet s’en passe : le travail peut avoir eu lieu auparavant. L’option Disable cache de Chrome désactive le cache du navigateur pendant que les outils sont ouverts ; elle ne purge pas le cache d’un CDN distant. Mode d’emploi du panneau Réseau, Chrome.
Pour un premier diagnostic, voici une grille de lecture, avec des pistes plutôt que des verdicts :
| Ce que tu observes | Ce que tu peux vérifier ensuite |
|---|---|
| Le nom ne se résout pas | L’orthographe de l’hôte et le résolveur DNS |
| La connexion échoue ou expire | Le service en écoute, le réseau et les filtrages |
| Le navigateur affiche une erreur de certificat | Le nom couvert, la validité du certificat et l’horloge |
| Une réponse HTTP 404 arrive | Le chemin demandé et le routage de la requête |
| Le document arrive, mais une partie reste vide | Les requêtes suivantes et les erreurs JavaScript |
Une 404 ne signifie pas automatiquement que ton code l’a produite : un proxy peut aussi répondre. Ce qui compte est d’identifier la dernière étape dont tu as une preuve, puis de creuser la suivante.
La prochaine étape de notre exploration sera le DNS : comment un nom trouve son serveur, et pourquoi une ancienne adresse peut parfois s’accrocher plus longtemps que prévu.
Reçois le prochain par email
Les nouveaux articles et séries, envoyés à leur publication. Aucun autre courrier.