La régisseuse ouvre l’application de planning des passages en scène pour vérifier le prochain changement de plateau. Rien ne charge. La répétition va commencer, l’équipe a besoin du planning et l’application fonctionnait encore quelques instants plus tôt. Près de la console de régie, TOP Infra s’arrête net : « Les workloads tournent. Qu’est-ce qui a changé autour d’eux ? »
Tous deux connaissent le système et le déroulement du festival. Ils ne devinent pas la cause. Une récente mesure d’isolation a peut-être fermé davantage que le chemin prévu ; ils décident donc de tester séparément la résolution du nom et le trafic applicatif. Cet épisode transforme la situation en exercice contrôlé : le festival est fictif, les manifests et le protocole sont téléchargeables. Le terrain est un cluster kind jetable avec Cilium, pas VKS ni un environnement de production.
Écrire le contrat avant de fermer la porte
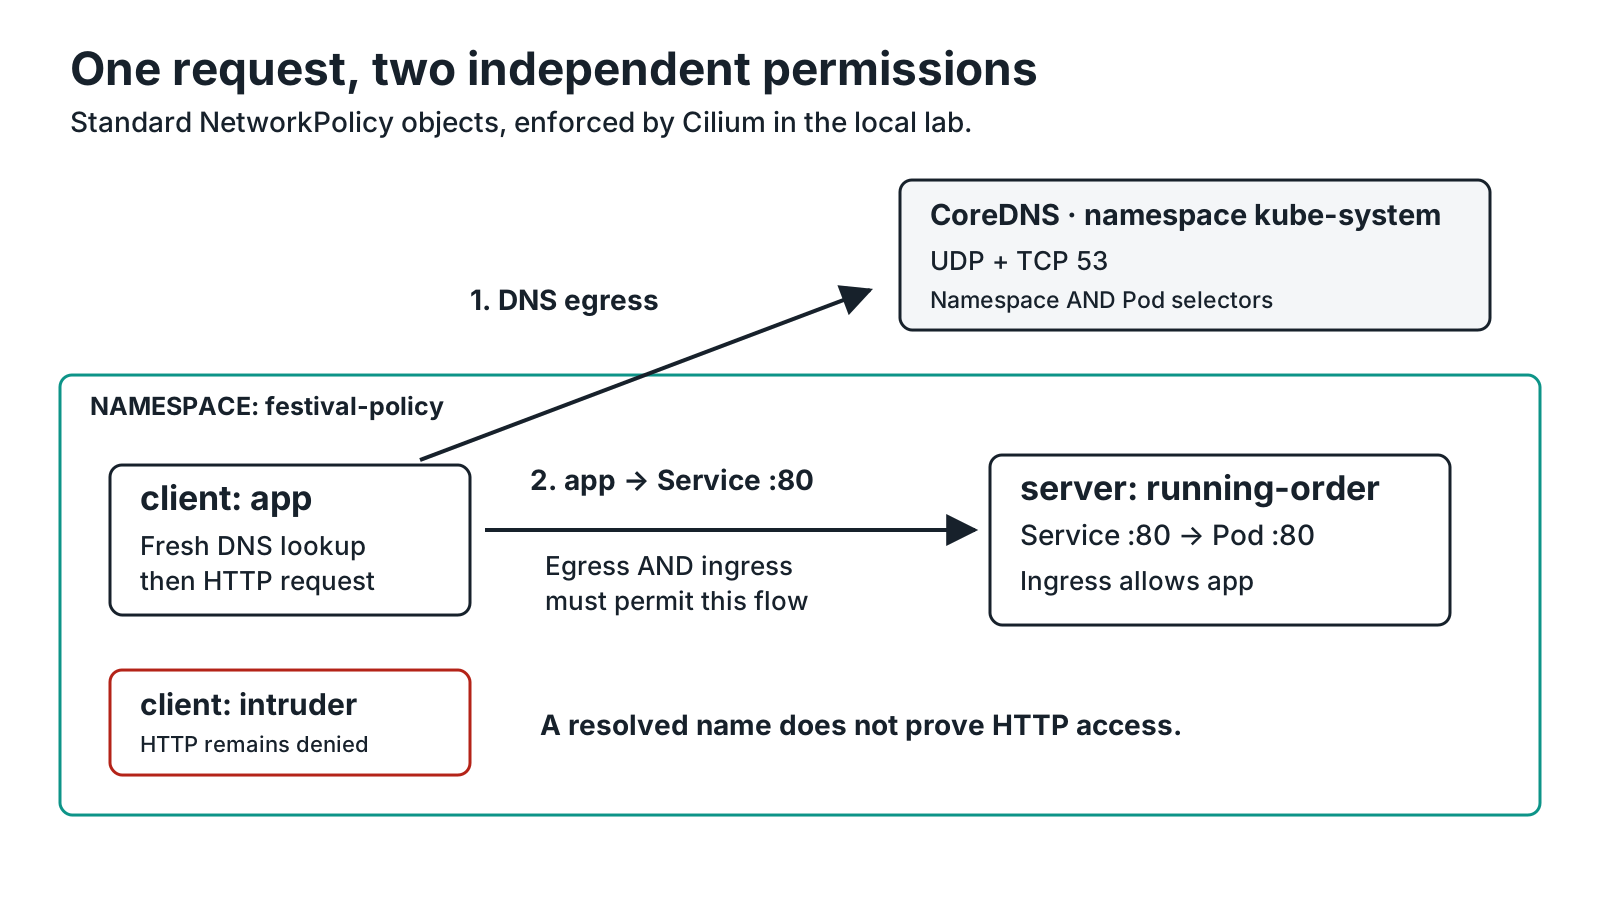
Le lab contient un namespace festival-policy, un Deployment et un Service HTTP nommés running-order, deux clients, app et intruder, chacun géré par un Deployment. Ce dernier est un témoin négatif, pas la représentation d’un attaquant. S’il peut récupérer le planning après l’ouverture du chemin applicatif prévu, l’isolation n’est pas démontrée.
Le Service écoute sur TCP 80 et transmet au Pod serveur sur TCP 80. Les clients utilisent running-order.festival-policy.svc.cluster.local. Dans ce cluster, le DNS provient des Pods CoreDNS de kube-system, identifiés par k8s-app=kube-dns. Ce sont des choix du lab ; un autre cluster peut employer un domaine différent ou NodeLocal DNSCache et nécessiter une autre politique.
Les objets d’isolation sont des NetworkPolicy Kubernetes standard. Cilium les applique dans ce lab : aucune règle L7, aucun toFQDNs ni migration de CNI ne sont configurés. Garde le guide NetworkPolicy et Cilium à côté pour les différences de capacités et les limites VKS. Référence : ressources de politique prises en charge par Cilium.
Télécharge le bundle complet du lab. Les scripts, manifests et instructions FR/EN restent consultables dans le README. Les versions et digests épinglés sont inscrits dans setup.sh et cluster.yaml : lis-les plutôt que de remplacer silencieusement une image par latest.
Périmètre de validation
Cet article décrit un protocole de lab local. « Ce qui a réellement été vérifié » renvoie au compte rendu de validation et distingue les résultats exécutés des résultats attendus. La création des ressources ne prouve pas à elle seule le filtrage, et un test kind ne valide pas VKS.
Observer avant d’appliquer default-deny
Avant de modifier la politique, TOP et la régisseuse établissent un état de référence. Ils vérifient les endpoints du Service, résolvent son nom complet et envoient une nouvelle requête HTTP depuis les deux clients. L’ordre est important : un échec de téléchargement d’image, un mauvais label, un endpoint absent ou un serveur arrêté pourrait sinon passer pour un filtrage réussi. Le bundle utilise des noms et labels simples à inspecter.
Sur une machine de lab avec Docker actif, kind, kubectl et Helm, décompresse l’archive, lis les scripts puis lance :
chmod +x setup.sh verify.sh cleanup.sh
./setup.sh
./verify.sh
setup.sh prépare un cluster dédié nommé top-cilium avec un kubeconfig séparé. verify.sh déroule le scénario et conserve des sorties horodatées. Vérifie leur emplacement avant de partager les traces : elles ne doivent contenir ni identifiants d’un autre cluster ni secrets. Ne change pas le contexte de ton terminal pour contourner une commande refusée par une garde.
Sans politique, le résultat attendu est une résolution DNS fraîche et une réponse HTTP réussie depuis app comme depuis intruder. Le serveur renvoie exactement le texte témoin « Festival running order: soundcheck, doors, opening set ». Si une requête échoue dès le départ, le duo s’arrête pour examiner les endpoints et l’état du serveur avant de continuer. Un point de départ cassé ne permet pas de savoir ce que la règle d’isolation a changé.
Les noms DNS des Services facilitent la découverte ; ils ne constituent pas une autorisation réseau. Un nom peut être résolu alors que l’accès à sa destination reste bloqué. Référence : DNS des Services et Pods.
Faire apparaître le refus, puis rétablir DNS
Le manifeste 10-default-deny.yaml sélectionne tous les Pods du namespace dans les deux directions :
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny
  namespace: festival-policy
spec:
  podSelector: {}
  policyTypes:
    - Ingress
    - Egress
On ne cherche pas un champ deny: true. Ce manifeste sélectionne les Pods sans ajouter de flux autorisés. Les permissions éventuelles d’autres politiques resteraient importantes ; c’est pourquoi l’exercice part d’un namespace neuf. Une connexion entre deux Pods isolés exige que les politiques pertinentes l’autorisent des deux côtés. Référence : modèle NetworkPolicy.
Le duo relance des tests à délai borné. À ce stade, DNS et HTTP vers la ClusterIP connue sont attendus bloqués. Tester l’adresse connue évite de confondre « impossible de résoudre le nom » avec « HTTP aurait été accepté ». L’application de planning reste inaccessible ; le duo dispose maintenant d’un refus précis à examiner plutôt que d’une panne générale.
20-allow-dns.yaml autorise la sortie vers CoreDNS en UDP et TCP 53. Son namespaceSelector et son podSelector se trouvent dans la même entrée de destination : le namespace et le label du Pod doivent tous deux correspondre. Les séparer en deux entrées élargirait les destinations.
Cette autorisation rétablit la résolution ; elle n’autorise pas l’application de planning. Le résultat attendu devient DNS fonctionne, HTTP reste bloqué. C’est une preuve plus utile qu’un simple « le réseau remarche ». L’accès au résolveur ne filtre pas les noms demandés. Le lab ne prouve pas non plus qu’un Pod CoreDNS isolé en entrée accepterait ces paquets : notre default-deny applicatif n’isole pas le namespace système. Pour un autre déploiement DNS, commence par identifier le résolveur réellement utilisé. Méthode de diagnostic DNS Kubernetes.
Autoriser le chemin applicatif, puis vérifier le témoin
Le manifeste 30-allow-app-to-running-order.yaml fournit les deux moitiés du trajet : la sortie du client app vers le Pod serveur portant le label app=running-order, et l’entrée vers ce Pod depuis app. Les sélecteurs restent dans le namespace du lab. La destination applicative est TCP 80, le port du Pod derrière le Service TCP 80.
Le témoin intruder conserve l’autorisation DNS de la règle commune, mais ne reçoit aucune autorisation HTTP. Deux résultats doivent coexister : app récupère exactement la réponse témoin du planning et intruder ne l’obtient pas. Une seule requête réussie ne remplace jamais cette comparaison.
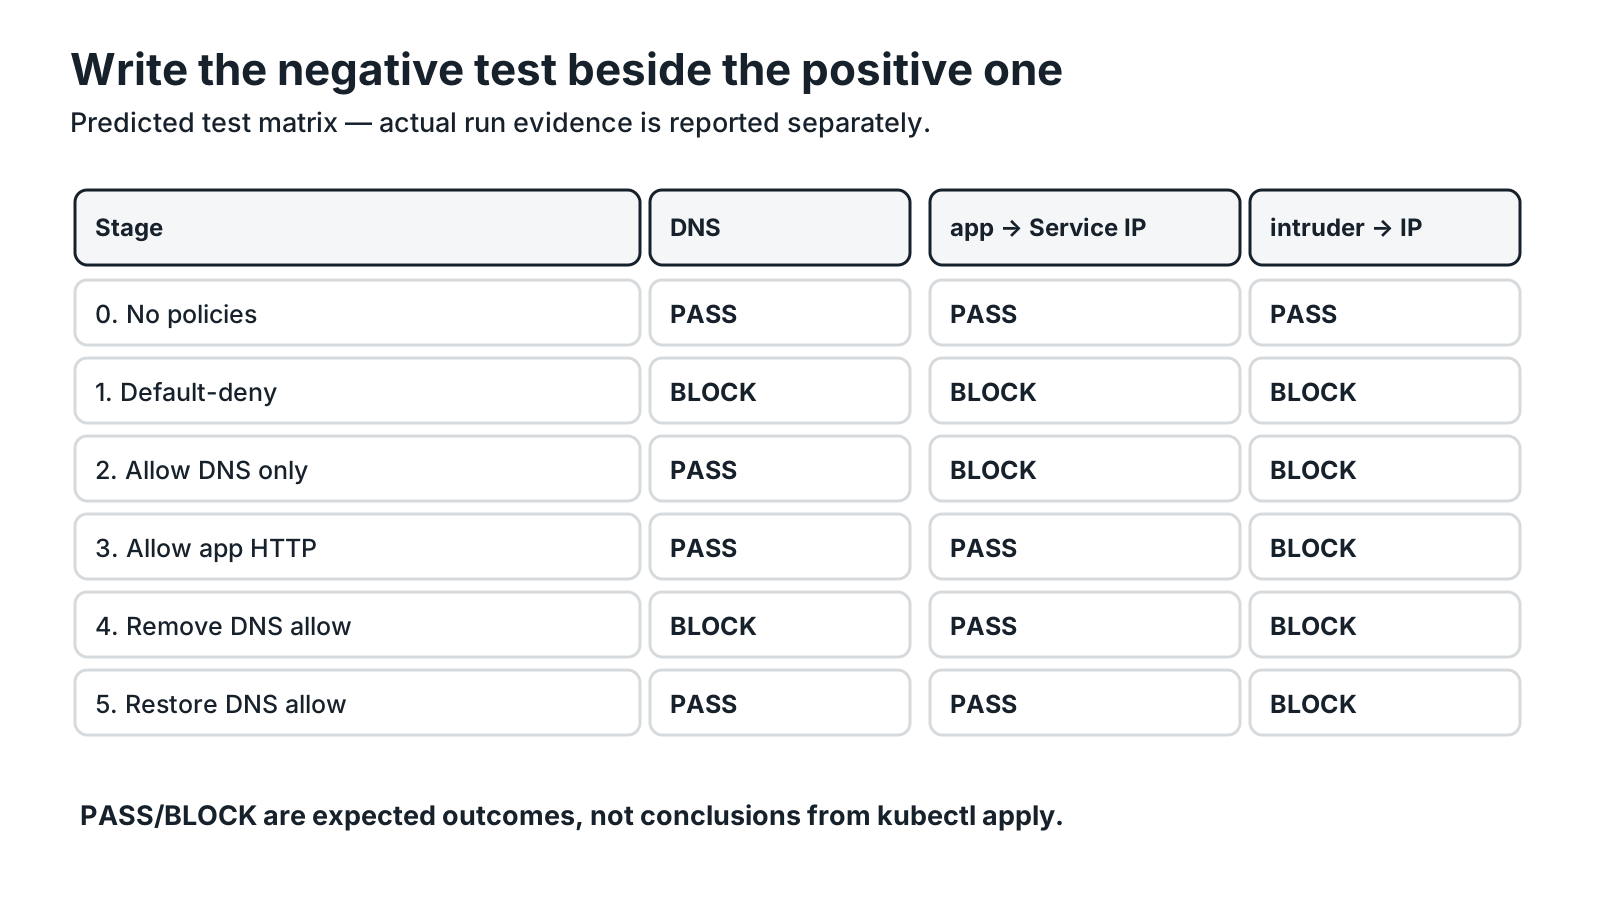
Pour terminer l’investigation, le script retire seulement l’autorisation DNS. Le client conserve l’adresse du Service relevée précédemment. Sur de nouvelles tentatives, la résolution est attendue en échec tandis que l’accès HTTP direct depuis app reste possible. La règle DNS est ensuite rétablie et les deux vérifications sont rejouées. Ce dernier contraste montre pourquoi il faut observer séparément DNS et l’accès applicatif.
Cette variation reste volontairement limitée. Une application réelle peut mettre les réponses DNS en cache, conserver des connexions ou utiliser plusieurs résolveurs. Un test négatif doit donc préciser le processus, la destination, le délai et les conditions de nouvelle connexion. Ce protocole ne mesure ni débit, ni latence, ni résistance à une attaque. Un timeout borné n’établit pas à lui seul la cause dans un cluster quelconque.
Ce qui a réellement été vérifié
Le bundle festival final a été installé depuis zéro le 2 novembre 2026 avec kind 0.31.0, Kubernetes 1.35.0 et Cilium 1.20.4. Deux exécutions ont chacune réussi 16 assertions sur six phases, dont la réinitialisation du namespace de lab existant. Ouvrir DNS n’a pas rouvert HTTP ; autoriser app a laissé intruder bloqué ; retirer DNS a conservé HTTP par adresse connue pour app. Le cluster dédié a été supprimé après vérification.
Le bundle téléchargeable contient le compte rendu de validation VALIDATION.md, avec les résultats détaillés, les preuves et les limites. Il consigne le protocole local et les résultats observés ; les autres résultats sont explicitement présentés comme attendus. Aucune sortie simulée n’est présentée comme un résultat Cilium.
Le périmètre reste local : aucun déploiement VKS exécuté, aucun CNI remplacé sur une plateforme existante, aucun journal Hubble supposé et aucun résultat de performance. D’autres politiques ou paramètres Cilium demandent de nouvelles observations dans leur contexte. Les modes d’application Cilium font partie des paramètres à consigner.
Fermer le lab et garder la bonne habitude
Avant de supprimer le cluster, conserve les versions, les manifests appliqués, les résultats positifs et négatifs, ainsi que les modifications effectuées entre chaque paire de tests. Nettoie ensuite uniquement ce lab :
./cleanup.shLe script de nettoyage vise top-cilium. Il ne sert pas à supprimer un namespace sur une plateforme partagée. Ne remplace pas sa garde par ton contexte habituel et ne copie pas des commandes destructrices dans un runbook de production.
Avec les vérifications consignées, ils peuvent nommer le flux autorisé, celui qui reste refusé et le test qui les distingue. La prochaine panne pourra commencer avec cette petite matrice plutôt qu’une règle plus large. Pour continuer, l’épisode réseau VKS suit DNS, Service et endpoints ; le déploiement avec un sélecteur cassé propose une autre panne, à ne pas confondre avec une politique réseau.
Reçois le prochain par email
Les nouveaux articles et séries, envoyés à leur publication. Aucun autre courrier.