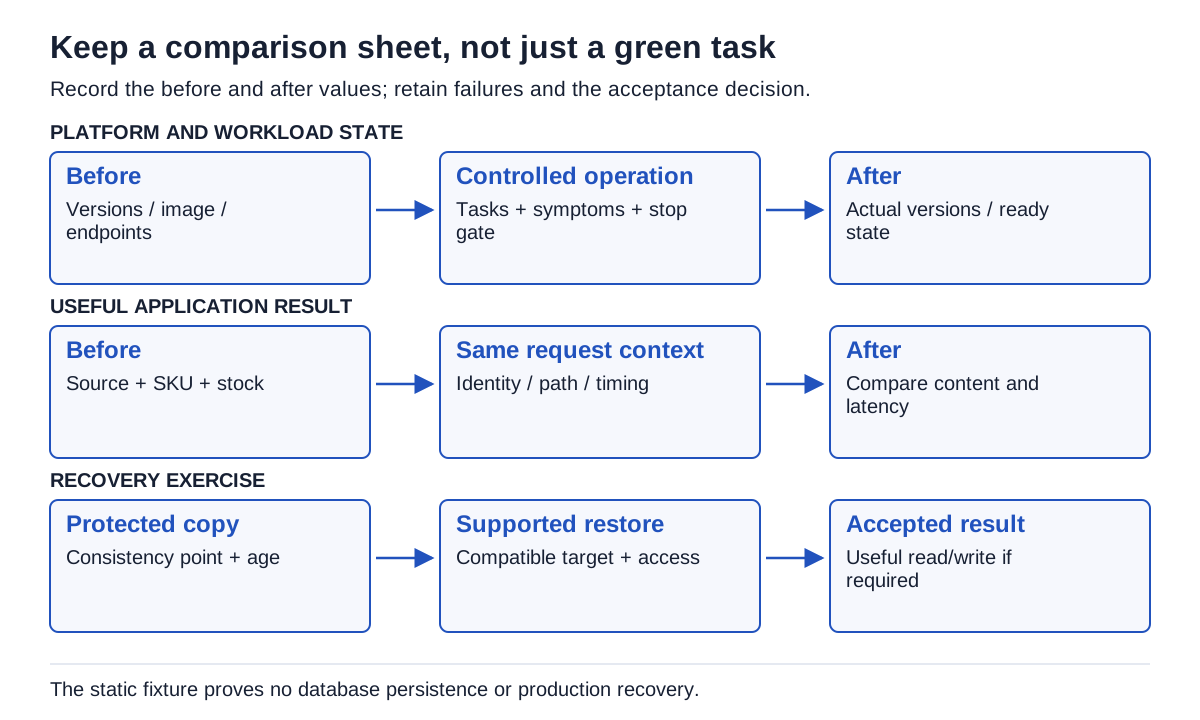
Devant le calendrier de l’équipe, TOP marque la fenêtre de maintenance pendant que son collègue relit la checklist. « Avant la fenêtre, notons la version du menu et l’identifiant d’une commande confirmée pour pouvoir comparer. » Pause Café fonctionne aujourd’hui ; il faut savoir ce que l’on observera pendant l’opération et après.
Le contrat applicatif nous donne deux contrôles concrets à préserver : la version du menu statique et l’identifiant d’une commande confirmée. Une maintenance achevée et un service utile demandent des preuves différentes.
Nous avons maintenant une première application et une panne volontaire que nous savons expliquer. Le quotidien commence quand il faut changer son environnement tout en respectant le contrat de service. TOP Dev suit les effets sur les requêtes et les données, tandis que l’équipe plateforme exécute le processus de cycle de vie pris en charge.
Cet article a été révisé le 27 octobre 2026. La démarche propose un cadre de préparation et de recette ; elle ne prétend pas décrire une mise à niveau VKS réellement effectuée. Le petit exemple sans état de l’épisode trois aide à comprendre le chemin du Service. Les applications de production, notamment les bases de données, nécessitent des tests supplémentaires de restauration et de cohérence.
Trois décisions de version, puis un parcours pris en charge
Distingue la version de la plateforme et du Supervisor, la version du service VKS installé et la version Kubernetes du cluster de workloads. Avant de choisir un ordre d’intervention, consigne les versions actuelles et les versions cibles. Ces cycles de vie sont distincts, mais restent soumis à des limites de compatibilité.
Consulte la matrice d’interopérabilité officielle et les notes de version, en tenant compte des clusters de workloads existants et des extensions installées. Modifier le service VKS n’est pas la même opération que changer la version du cluster de workloads. Un parcours pris en charge peut exiger des étapes intermédiaires : ne transforme pas une version supposée en plan de mise à niveau. Broadcom KB 455622.
Pour les environnements qui mettent vCenter à niveau vers 9.1.0 ou 9.1.1, tiens compte de l’avis ciblé publié par Natalie Fisher le 9 octobre 2026, avant la mise à niveau. Il signale un risque pour les VM du control plane Supervisor et les Foundation Load Balancers lorsqu’une réinitialisation antérieure du dépôt vLCM/VUM a laissé des incohérences dans la base de données. Avec le responsable plateforme, vérifie les versions sources concernées ainsi que les validations et corrections requises. Les scripts de réparation relèvent de la procédure officielle ; ce n’est pas un exercice destiné à l’équipe applicative. Avis et articles KB associés.
Cet avis ne signifie pas que chaque déploiement applicatif ou correctif limité aux workloads déclenche le même risque. Il montre qu’affirmer que « tout est indépendant » omettrait une condition préalable importante de la plateforme.
Réconcilier la source de vérité, pas la VM qui en résulte
La spécification d’un cluster VKS est réconciliée en infrastructure de nœuds par des contrôleurs gérés. Si le parcours utilise une topologie gérée, modifie sa source prise en charge ou le modèle approuvé au lieu de changer directement les MachineDeployments générés ou le matériel des VM. Cette source peut appartenir à un portail ou à un dépôt Git : identifie son propriétaire avant toute modification.
Distingue ce que tu modifies avant de choisir la source à éditer :
| Modification | Source à modifier | Effet à vérifier |
|---|---|---|
| Replicas applicatifs | Deployment de l’application | Nouveaux Pods et placement admissible sur les nœuds existants |
| Capacité des workers | Spécification de cluster ou modèle approuvé | Ajout/retrait de nœuds et déplacement éventuel des Pods |
| Classe de VM | Source prise en charge par le workflow de plateforme | Remplacement possible des workers |
Demande quel effet le champ envisagé déclenche dans la version installée ; le résultat dépend du workflow et de la topologie.
Le rebase d’une ClusterClass peut aussi avoir des conséquences. KB 439754 décrit un cas où il est valide de conserver une ancienne ClusterClass et où passer à un nouveau schéma peut déclencher un rollout. Choisir une classe dont le nom paraît plus récent ne constitue pas, à lui seul, un objectif de maintenance.
Capacité disponible et règles d’interruption vont de pair
Le remplacement d’un nœud peut demander temporairement plus de CPU, de mémoire, d’adresses IP et de stockage que la cible en régime normal. L’application doit aussi pouvoir être replanifiée sur un emplacement admissible. Les demandes de ressources, sélecteurs de nœuds, affinités, règles de répartition topologique, taints et contraintes des volumes peuvent empêcher un nouveau Pod d’utiliser une capacité qui semble pourtant libre.
Le Deployment de démonstration a deux réplicas, mais ne garantit pas qu’ils se trouvent sur des nœuds ou des domaines de panne distincts. Une conception de production doit exprimer la répartition voulue et la vérifier. Deux processus sur le même nœud en panne n’offrent pas la séparation recherchée.
Un PodDisruptionBudget, ou PDB, limite les évictions volontaires qu’il couvre. Pour un service répliqué adapté, voici un budget possible :
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: coffee
  namespace: coffee-demo
spec:
  minAvailable: 1
  selector:
    matchLabels:
      app: coffee
Cet exemple facultatif est à évaluer selon le service. Il ne crée pas de réplicas, ne réserve pas de worker et n’empêche pas une panne involontaire. Il ne régit pas non plus le comportement d’une mise à jour progressive de Deployment de la même manière qu’une éviction lors du drainage d’un nœud. Son sélecteur doit couvrir les Pods visés. Interruptions et configuration des PDB.
Avant la maintenance, examine les budgets et les contraintes de planification. Une éviction bloquée est une information utile : l’opération demandée ne peut pas respecter ce budget dans l’état actuel. Examine les réplicas indisponibles, leur placement, la capacité et la reprise de l’application. Supprimer le budget à l’aveugle peut remplacer une mise à niveau bloquée par une interruption de service.
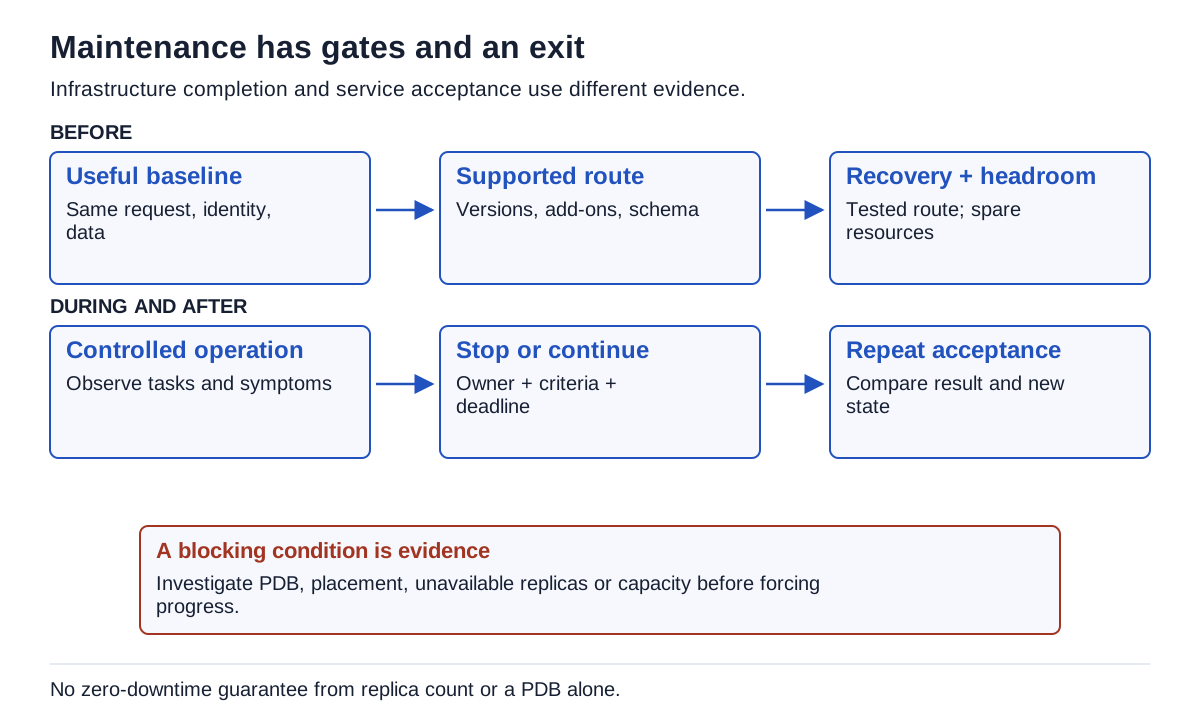
La décision d’arrêter se prend pendant le changement. La dernière tâche d’infrastructure passée au vert ne suffit pas à valider l’intervention.
Préserver les données nécessaires après une reconstruction
Le menu statique du fixture est une configuration sans état. Réappliquer son manifeste reconstruit la même réponse GET ; cela ne dit rien sur les commandes. Le stock et les commandes de l’application de référence sont dans PostgreSQL partagé et exigent sauvegarde, cohérence et validation de restauration de la base.
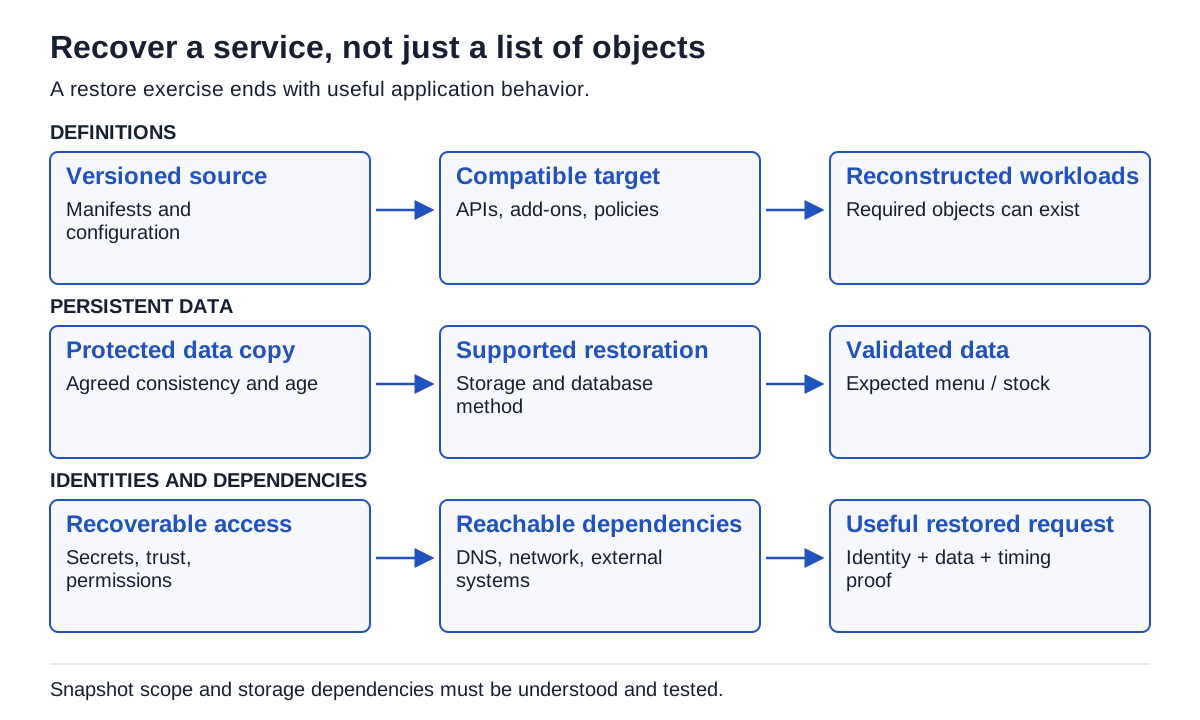
TOP distingue les couches de reprise :
| Couche | Élément à pouvoir restaurer | Preuve attendue |
|---|---|---|
| Gestion de la plateforme | Configuration prise en charge et reprise des composants de gestion | Procédure détenue par la plateforme, adaptée à la version |
| Définition des workloads | Manifestes relus, API et extensions requises, configuration | Reconstruction sur une cible compatible |
| Données persistantes | Contenu de la base ou des PV avec un point de cohérence convenu | Restauration et validation utile en lecture/écriture |
| Identité et dépendances | Secrets, confiance envers les autorités de certification, permissions, DNS et services externes | L’application restaurée peut effectuer l’action attendue |
TOP et un collègue demandent au responsable de base de restaurer un point PostgreSQL connu, puis vérifient qu’un identifiant de commande confirmé est toujours lisible après reprise.
Pour sauvegarder les applications VKS, choisis la méthode prise en charge et les composants compatibles décrits dans le guide Velero de Broadcom. Vérifie ce qui est capturé, où sont conservées les copies, qui peut les lire et comment les données des volumes sont protégées. La réussite d’une sauvegarde des objets ne prouve pas, à elle seule, que le contenu de la base est exploitable.
La documentation de Velero sur la reprise après sinistre décrit la restauration sur une cible préparée. Entraîne-toi à préparer cette cible et à valider l’application. Si tu utilises des snapshots, comprends leurs garanties de cohérence et leurs dépendances de stockage. Ne confonds pas un snapshot de VM quelconque, ni un snapshot conservé sur le même système, avec une sauvegarde indépendante qui a été testée.
Suivre le changement, de l’infrastructure jusqu’à la requête
Avant la fenêtre d’intervention, désigne un responsable du changement, une échéance de décision et un parcours de reprise adapté à l’état atteint. Consigne les résultats de référence : succès des requêtes, latence, erreurs, image réellement utilisée et contrôles de données utiles. Détermine quelles défaillances imposent l’arrêt et prévois assez de temps pour réagir.
Pendant l’opération de cycle de vie prise en charge, mets en relation sa tâche ou son état de réconciliation avec la disponibilité des nœuds, le placement des Pods, les redémarrages, les rattachements de volumes et les symptômes visibles par les utilisateurs. Ne supprime pas une Machine et ne rétablis pas une VM de nœud au seul motif qu’un déploiement est lent. Cela peut perturber la réconciliation ou la cohérence des données. Un incident propre à une version doit suivre la procédure de support correspondante.
Pour observer les workloads avec les permissions de lecture nécessaires :
kubectl --context coffee-workload -n coffee-demo get deploy,pods,pdb -o wide
kubectl --context coffee-workload -n coffee-demo get events --sort-by=.metadata.creationTimestamp
kubectl --context coffee-workload -n coffee-demo get endpointslices -l kubernetes.io/service-name=coffee
L’accès aux nœuds et aux conditions détaillées de gestion peut être réservé à l’équipe plateforme. Transmets-lui l’heure précise et les symptômes applicatifs au lieu d’accorder à chaque responsable d’application un accès étendu au cluster.
Utilise les journaux, les métriques et, lorsqu’elles existent, les traces pour relier les défaillances aux opérations. Un indicateur utile pour le service comprend les erreurs et la durée des requêtes, pas seulement le CPU des hôtes. Choisis des collecteurs et des systèmes de stockage pris en charge dans l’environnement installé ; ne suppose pas qu’un ancien chart ou collecteur est toujours le choix par défaut. Le guide d’instrumentation de Prometheus présente les mesures utiles du point de vue de l’application.
Après l’opération, répète les contrôles de référence depuis le même réseau pertinent et avec la même identité. Vérifie les versions réellement installées, la santé de la réconciliation, le nombre attendu de réplicas et d’endpoints, la persistance et les dépendances externes. Si le contrat de service exige des écritures, teste une petite opération autorisée de lecture et d’écriture. Vérifie les nouvelles sauvegardes et alertes, puis conserve les preuves et les écarts restants.
Les réponses du menu statique avant et après sont conservées avec leur version et leurs quantités. TOP fait aussi vérifier l’identifiant durable d’une commande après maintenance. Au passage de relais, il remet ces observations à sa collègue : elle doit pouvoir comprendre ce qui a été contrôlé et ce qui reste à surveiller.
Le résultat transmis à la prochaine livraison
Une tâche terminée indique que l’opération d’infrastructure est achevée. La recette confirme que le comportement de service convenu a été démontré, y compris la capacité de reprise. Ce sont deux comptes rendus liés, mais leurs preuves diffèrent.
Pour l’exemple, nos preuves restent volontairement limitées : l’image sélectionnée, deux réplicas prêts, des endpoints Service utilisables et la réponse statique du menu, sa version et ses quantités. En production, ajoute les résultats de placement, de charge, de cohérence des données, d’authentification et de restauration. Si un retour à une version antérieure de l’infrastructure n’est pas pris en charge, un revert Git ne peut pas le rendre pris en charge ; le plan de reprise doit tenir compte de cette limite.
Le dernier épisode suit GitOps avec Argo CD : comment faire réconcilier le plan applicatif relu sans confondre un état de synchronisation vert avec une requête de menu réussie.
Reçois le prochain par email
Les nouveaux articles et séries, envoyés à leur publication. Aucun autre courrier.