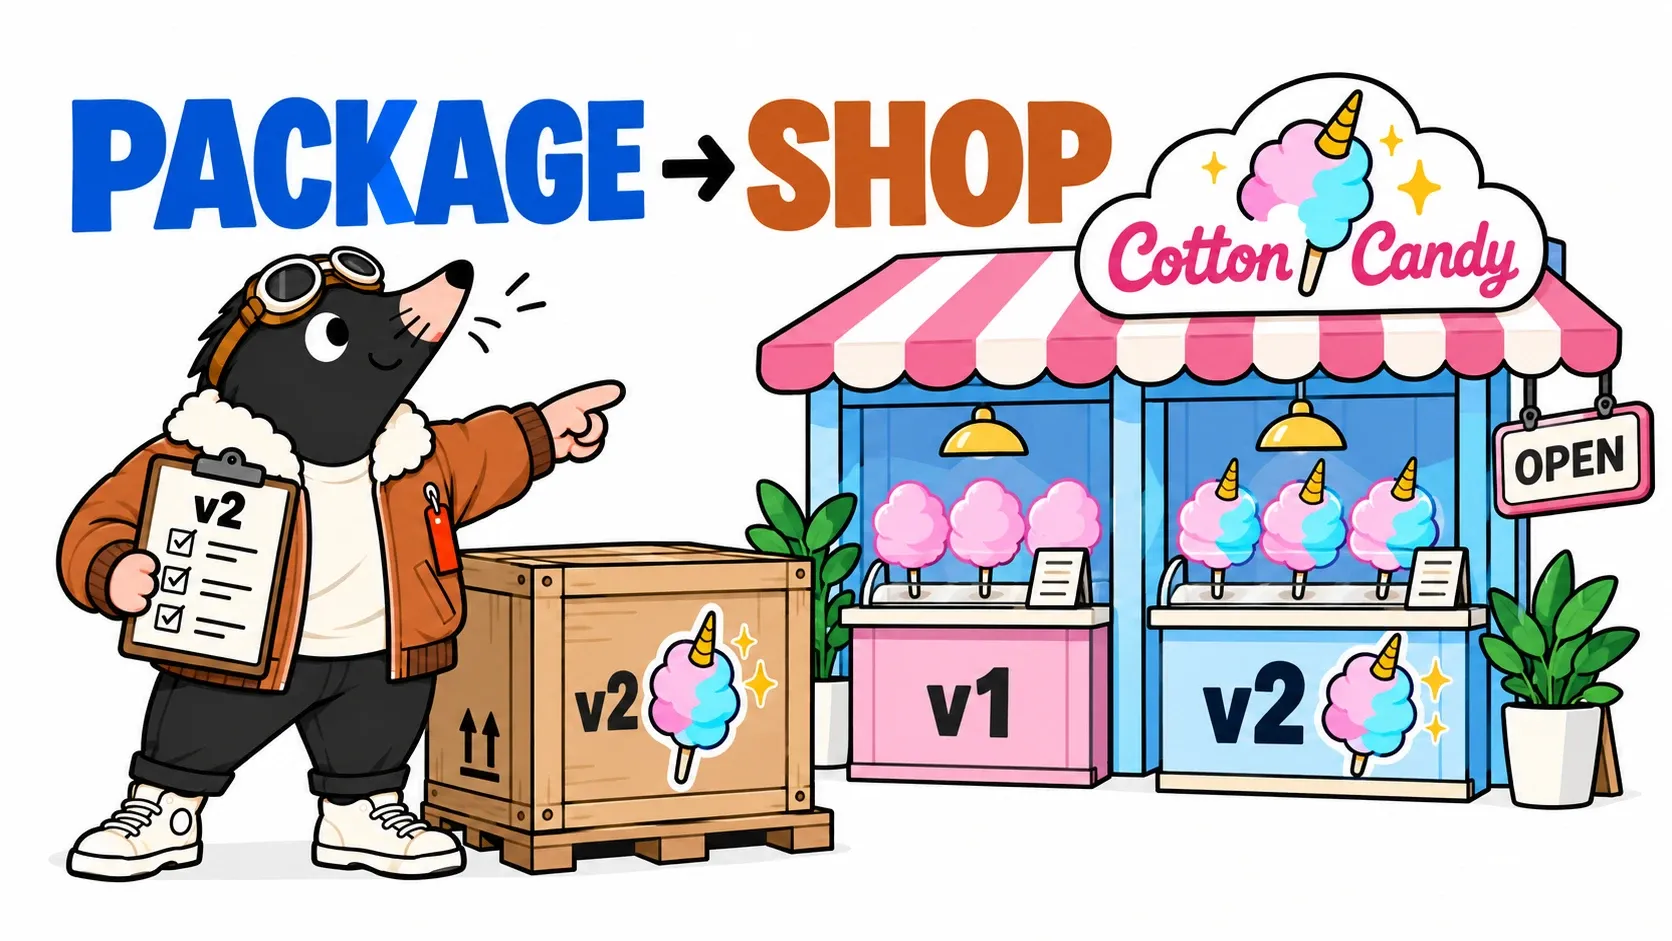
TOP et un collègue comparent sur le portable le manifeste aux deux réplicas en cours d’exécution. Cet exercice sert un menu statique ; les commandes et PostgreSQL relèvent de l’application de référence distincte.
Nous allons séparer deux étapes : obtenir le cluster de workloads par le workflow pris en charge, puis déployer le petit service à l’intérieur. Le fixture permet d’observer la sélection du Service et la livraison de configuration Kubernetes. Il n’implémente ni l’API de commande de l’application de référence ni sa persistance PostgreSQL.
L’épisode sur l’architecture a distingué deux API. L’épisode réseau a identifié le Service et ses backends. Ici, nous appliquons ces deux distinctions : d’abord obtenir un cluster de workloads par le workflow VKS pris en charge, puis déployer un petit exemple applicatif à l’intérieur de ce cluster.
Cette révision, vérifiée le 27 octobre 2026, fournit un exemple HTTP exécutable. L’exemple NGINX fourni expose seulement un menu fixe, sans base de données, volume persistant, TLS ni passerelle externe ; ses réponses v1/v2 et ses probes ont été vérifiées en conteneur local. Il ne crée aucune commande et ne prouve ni persistance ni intégration VKS. L’application de référence distincte utilise un front et une API reliés à PostgreSQL partagé : POST /orders accepte un SKU et une quantité avec un Idempotency-Key, renvoie 201 et un identifiant ; GET /orders/{id} peut confirmer l’enregistrement durable. Le labo local ne fournit pas de SSO ; en production, la plateforme doit appliquer l’identité et les autorisations requises. Ce statut HTTP ne promet ni préparation ni livraison du café. Aucun déploiement VKS n’est revendiqué. Le parcours navigateur → API HTTP → PostgreSQL est documenté et vérifié dans le labo local Pause Café ; le manifeste et les instructions VKS restent l’exercice stateless distinct. Les écrans de la BD mettent en scène le service ; le fichier fourni se limite à son endpoint HTTP.
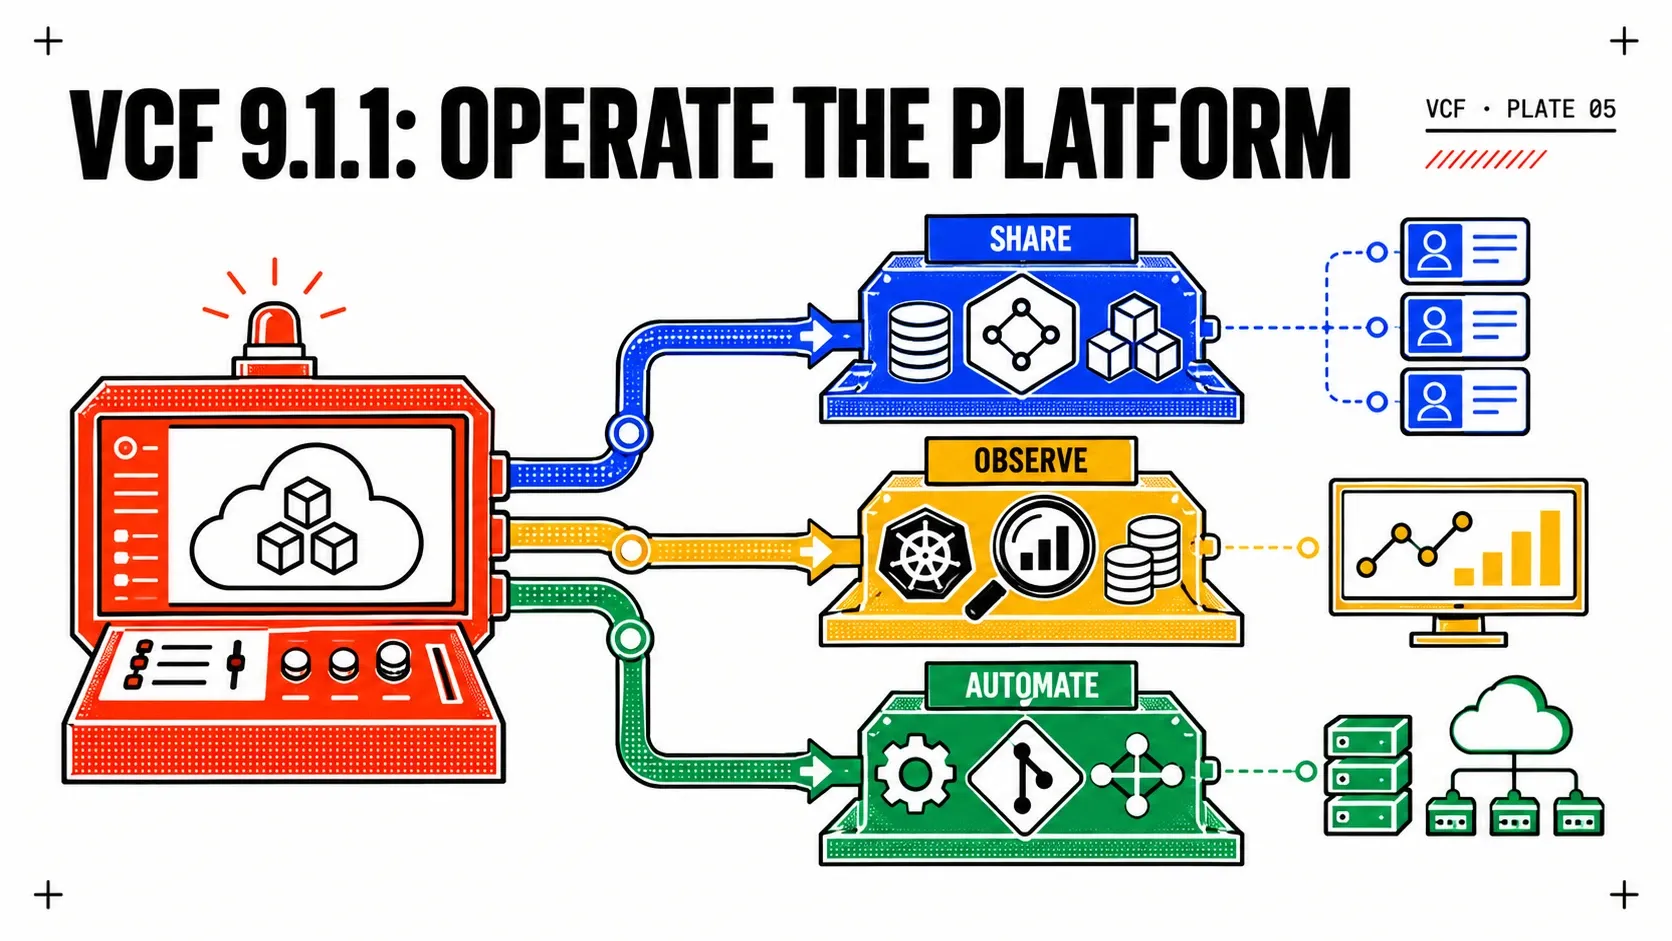
Provisionner l’environnement avec l’équipe plateforme
Nous appelons l’allocation de gestion team-coffee, son cluster de workloads coffee-vks, et le namespace applicatif prévu ensuite coffee-demo. Ce sont des exemples, pas des noms qui doivent exister sur ta plateforme.
Avant le provisionnement, obtiens une taille et une topologie approuvées, un plan d’adressage, les capacités de stockage, l’accès au registre et la configuration d’identité et de confiance. Vérifie que le quota libre et la capacité d’infrastructure suffisent pour la création et un remplacement ultérieur. Trois réplicas du control plane répartis entre des domaines de panne appropriés peuvent protéger le quorum contre certaines défaillances ; le nombre trois, à lui seul, ne garantit ni la résilience du site ni la disponibilité de l’application.
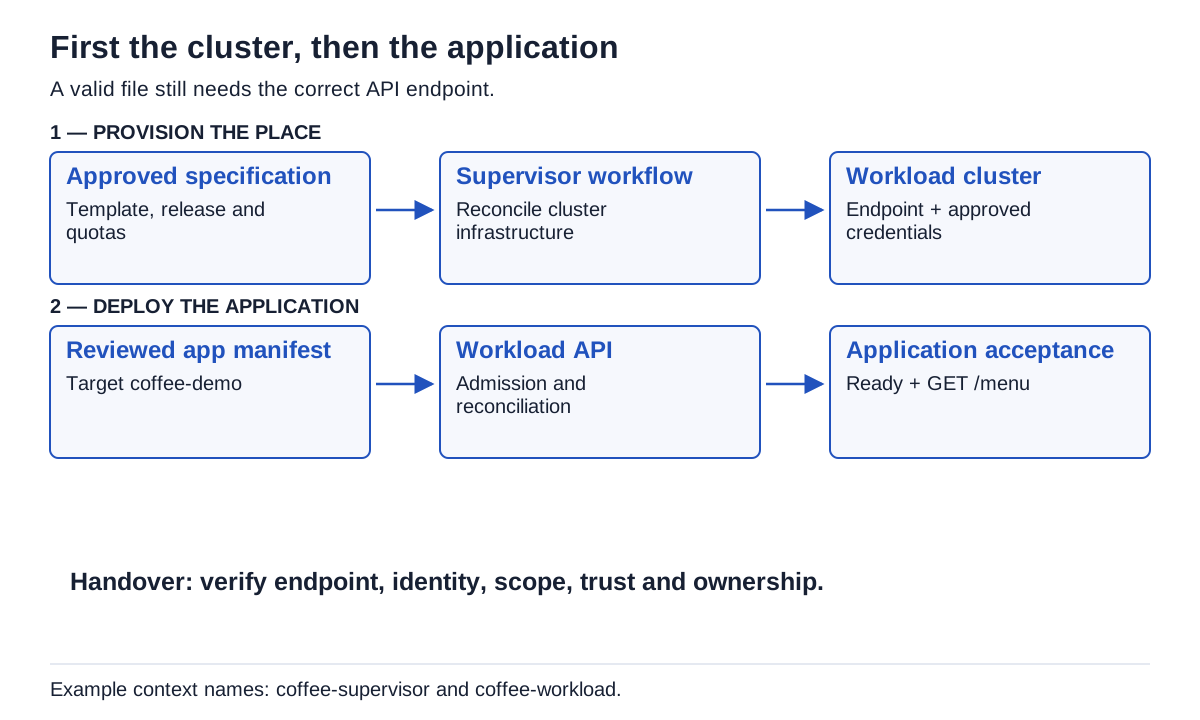
Deux soumissions à deux endpoints, avec des responsables et critères de recette distincts. Aucune version produit n’est déduite de la seule étiquette VCF.
Suis le portail, le catalogue ou le workflow Supervisor/API pris en charge par ta plateforme :
- Consigne les versions réelles de vCenter/Supervisor, du service VKS et les versions Kubernetes proposées. Vérifie leur compatibilité.
- Sélectionne un modèle de cluster ou une ClusterClass approuvés par la plateforme, avec leur schéma de variables réel.
- Examine la spécification générée : noms, topologie, classes de VM, stockage, version et allocations réseau.
- Si ton workflow repose sur des manifestes, valide et soumets cette spécification au Supervisor avec l’autorisation requise. Si un portail l’a déjà soumise, observe cette opération au lieu de créer un deuxième cluster.
- Suis la réconciliation et les événements jusqu’à ce que les critères de disponibilité de la plateforme soient atteints. Examine les erreurs à la couche qu’elles désignent.
- Récupère l’endpoint du workload ainsi que l’accès ou le kubeconfig approuvés par le workflow d’identité pris en charge, sans désactiver la vérification des certificats.
Un ancien exemple tanzukubernetescluster en v1beta1 avec une version figée ne constitue pas un modèle universel. Les ClusterClasses et schémas de variables VKS évoluent. La KB 404143 documente la conversion des schémas ; la KB 439754 explique pourquoi il peut être légitime de conserver une classe existante après une mise à niveau. Ne remplace pas cette classe uniquement pour faire correspondre son nom à la version VKS.
Avec la permission d’examiner l’API de gestion, découvre les ressources réellement exposées :
kubectl --context coffee-supervisor api-resources --api-group=cluster.x-k8s.io
kubectl --context coffee-supervisor -n team-coffee get clusters.cluster.x-k8s.io coffee-vks -o yaml
Ici, coffee-supervisor est le contexte kubeconfig local que tu as vérifié. Une réponse « forbidden » peut simplement refléter ton rôle. Demande au responsable plateforme l’observation nécessaire ; n’emprunte pas un kubeconfig root ou de support.
Identifier la cible avant d’appliquer l’application
Notre contexte de workloads s’appelle coffee-workload. Examine l’endpoint du cluster configuré, authentifie-toi par la méthode approuvée et vérifie l’accès au namespace. Évite d’imprimer un kubeconfig brut ou un jeton dans des journaux partagés.
kubectl config get-contexts
kubectl --context coffee-workload cluster-info
kubectl --context coffee-workload -n coffee-demo auth can-i create deployments.apps
kubectl --context coffee-workload -n coffee-demo get resourcequota,limitrange
L’équipe plateforme alloue coffee-demo, avec ses politiques de sécurité et de réseau. Le fichier d’exercice ne crée délibérément pas le namespace. Si l’admission rejette la requête, examine ces politiques ; l’exemple ne justifie pas de les désactiver.
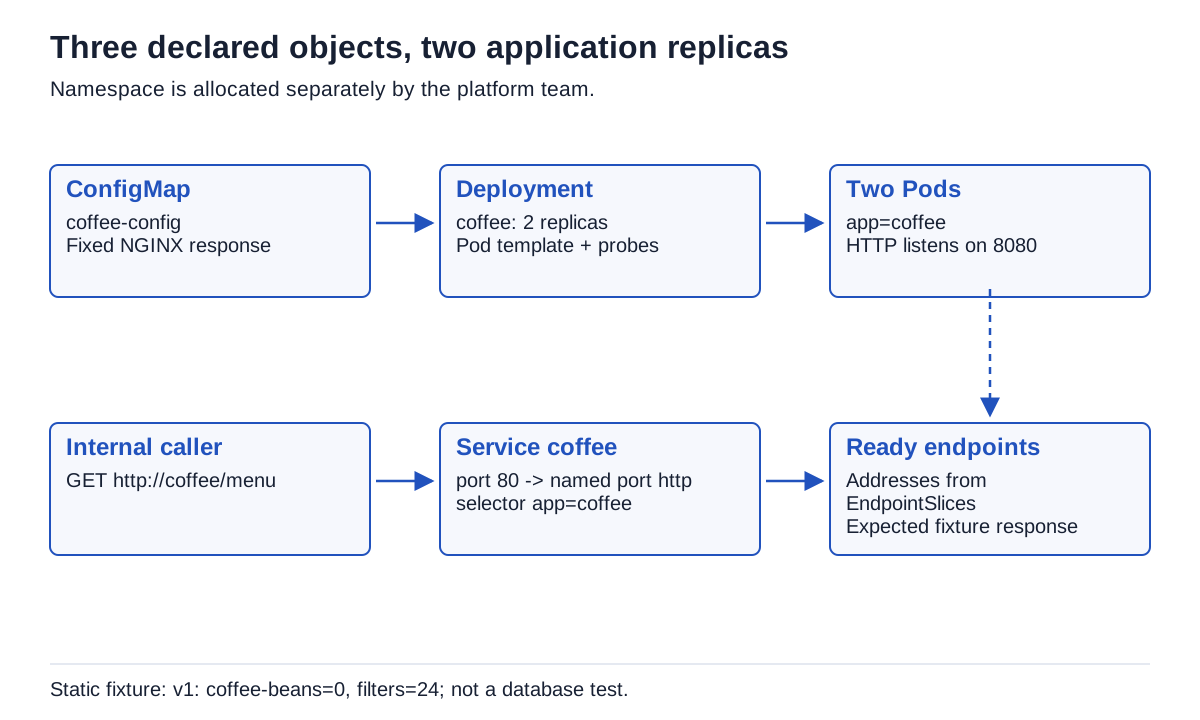
Trois objets rendent le petit service visible
Télécharge et examine workload.yaml, ainsi que sa portée et ses instructions. Le fichier crée exactement trois objets limités au namespace :
| Objet | Rôle dans cet exercice | Observation |
|---|---|---|
ConfigMap coffee-config |
Configuration NGINX et réponse fixe | GET /menu renvoie uniquement un fixture statique ; aucune commande ni persistance n’est prouvée |
Deployment coffee |
Deux copies du processus HTTP | Déploiement progressif, état des Pods, image réelle et disponibilité |
Service coffee |
Nom/port interne stable qui sélectionne ces Pods | Sélecteur et EndpointSlices prêts |
Le digest de l’image est épinglé et a été résolu le 26 octobre 2026 ; le conteneur et la nouvelle réponse ont été revérifiés localement le 27 octobre. L’exemple s’exécute avec un utilisateur non privilégié, abandonne ses capacités, utilise un système de fichiers racine en lecture seule et monte un espace temporaire inscriptible. Avant de réutiliser l’image, examine-la ainsi que la politique de ton registre. Le projet NGINX non privilégié documente ses exigences d’exécution.
La partie importante du Deployment se repère sans devoir apprendre tous les champs d’un coup :
# Excerpt of workload.yaml; not a standalone manifest.
spec:
  replicas: 2
  selector:
    matchLabels: { app: coffee }
  template:
    metadata:
      labels: { app: coffee }
    spec:
      containers:
        - name: http
          ports:
            - { name: http, containerPort: 8080 }
          readinessProbe:
            httpGet: { path: /ready, port: http }
Le modèle définit le contenu attendu de chaque réplica. Les étiquettes permettent la sélection. Le port nommé relie le targetPort du Service au port 8080. L’état Ready détermine l’admissibilité au trafic de service ordinaire. Voir les Deployments et le fonctionnement des sondes.
Nos gestionnaires /live et /ready renvoient des réponses fixes simples. Une vraie application doit définir des contrôles adaptés à son comportement. Redémarrer chaque processus parce qu’une base partagée est momentanément inaccessible peut aggraver l’incident ; une panne de dépendance et une panne locale du processus doivent être traitées différemment.
TOP rapproche deux étiquettes. Elles se ressemblent presque. « Presque, pour un selector, c’est déjà différent. » Il prend le temps de relier le nom demandé aux Pods réellement sélectionnés.
Appliquer, observer, puis lire les stocks
N’exécute ces commandes que sur la cible de workloads non destinée à la production qui t’a été allouée :
kubectl --context coffee-workload -n coffee-demo apply --dry-run=server -f workload.yaml
kubectl --context coffee-workload -n coffee-demo apply -f workload.yaml
kubectl --context coffee-workload -n coffee-demo rollout status deployment/coffee --timeout=120s
kubectl --context coffee-workload -n coffee-demo get pods -l app=coffee -o wide
La simulation côté serveur vérifie la requête auprès de cette API et du chemin d’admission sans enregistrer les objets. Elle ne prouve ni que l’image pourra être téléchargée ni qu’une requête réussira. Si le déploiement ne devient pas disponible, examine les événements des Pods et les journaux applicatifs avant d’augmenter indéfiniment le délai d’attente.
Pour une inspection locale, lance cette commande dans un terminal :
kubectl --context coffee-workload -n coffee-demo port-forward service/coffee 18080:80Dans un autre terminal, curl --fail http://127.0.0.1:18080/menu doit renvoyer exactement le fixture statique ci-dessous. GET /menu ne fait que lire cette réponse : il ne crée aucune commande et ne prouve ni données persistantes ni intégration VKS réelle. Par défaut, port-forward est lié aux interfaces locales. Il atteint un Pod sélectionné via le chemin d’accès Kubernetes ; il ne valide ni l’ingress externe, ni TLS, ni le transfert ClusterIP normal.
{"release":"v1","items":[{"sku":"coffee-beans","stock":0},{"sku":"filters","stock":24}]}Pour tester le Service interne depuis un Pod de démonstration, utilise la commande wget de l’épisode deux. Examine aussi les EndpointSlices. La liste renvoyée est le résultat utile ; les différents chemins précisent la portée de chaque test.
Casser le sélecteur sans arrêter les processus
Arrête port-forward avec Ctrl-C. Modifie uniquement le Service de démonstration temporaire :
kubectl --context coffee-workload -n coffee-demo patch service coffee --type merge -p '{"spec":{"selector":{"app":"typo"}}}'
kubectl --context coffee-workload -n coffee-demo get pods -l app=coffee
kubectl --context coffee-workload -n coffee-demo get endpointslices -l kubernetes.io/service-name=coffee -o yaml
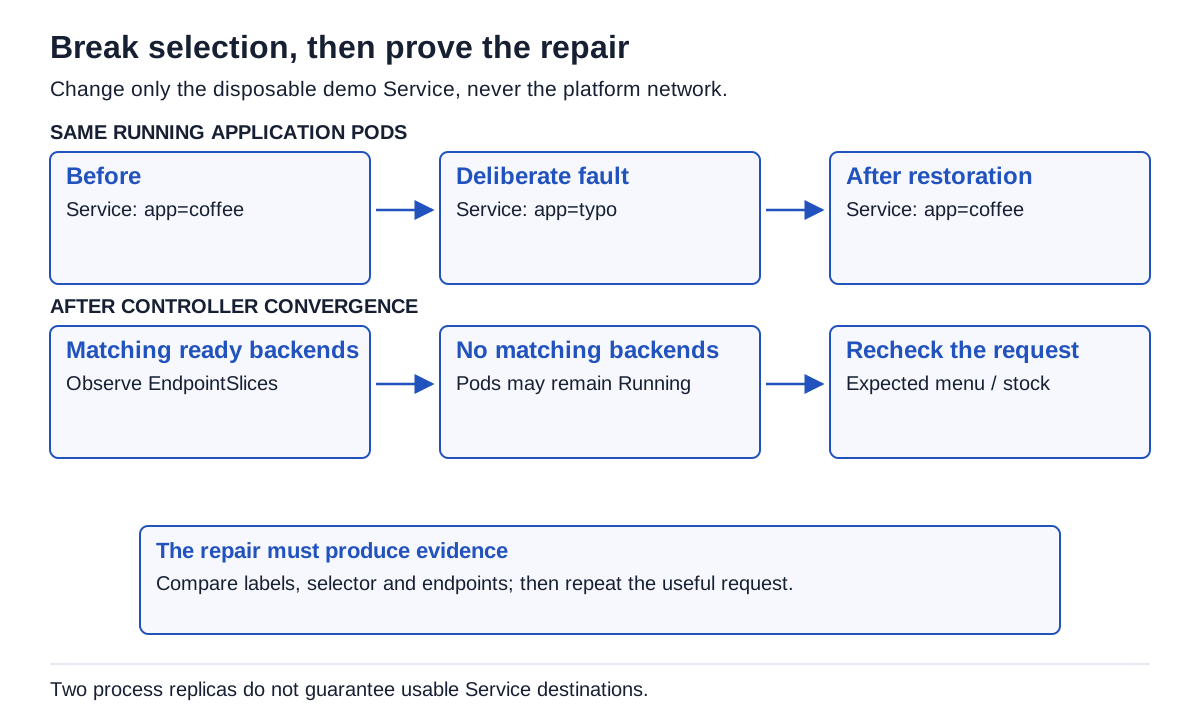
Le Deployment possède toujours ses deux Pods. Après convergence du contrôleur, le Service n’a plus de backend correspondant. Une requête interne ne peut plus atteindre l’exemple par cette sélection. C’est un défaut de sélection, pas une panne de pare-feu ou de câble physique.
Rétablis explicitement le sélecteur, puis répète les contrôles des endpoints et de la requête :
kubectl --context coffee-workload -n coffee-demo patch service coffee --type merge -p '{"spec":{"selector":{"app":"coffee"}}}'| Objet observé | Commande exacte déjà utilisée ici | Prouve / ne prouve pas | Après sélecteur cassé → réparé |
|---|---|---|---|
| Readiness des Pods | kubectl --context coffee-workload -n coffee-demo get pods -l app=coffee -o wide |
Lire le nombre de conteneurs prêts ; il ne prouve pas le routage du Service | Toujours prêts → toujours prêts |
| Endpoints du Service | kubectl --context coffee-workload -n coffee-demo get endpointslices -l kubernetes.io/service-name=coffee -o yaml |
Des backends prêts correspondent ; pas qu’une requête réussit | Aucune adresse prête → adresses rétablies |
| Requête locale du fixture | curl --fail http://127.0.0.1:18080/menu après un nouveau port-forward service/coffee 18080:80, comme ci-dessus |
Un Pod sélectionné répond par le tunnel API ; pas le ClusterIP normal, l’accès externe ni la persistance | Le nouveau tunnel ne trouve pas de Pod correspondant tant que cassé → le recréer après réparation, puis comparer la réponse |
Un curl en échec vers un tunnel arrêté ne prouve pas une panne du Service. Le test de sélection consiste à ouvrir un nouveau port-forward du Service ; la requête interne de l’épisode réseau exerce séparément son chemin normal. kubectl précise que port-forward choisit un Pod pour la session.
Consigne une observation réelle dans la fiche vierge de preuve du Service. L’article ne prétend pas rapporter une exécution VKS.
La réponse du menu revient après réparation du selector. TOP se lève pour reformuler la cause auprès de son collègue : les Pods sains continuaient à fonctionner, mais le Service n’en sélectionnait aucun. Il note le contrôle qui a confirmé la reprise.
Consigner le résultat et laisser le namespace propre
Consigne l’endpoint des workloads, le modèle et la version approuvés, le digest de l’image réelle, les Pods prêts, les endpoints correspondants et la réponse attendue. Note la panne volontaire et son rétablissement. Ces preuves suffisent à expliquer ce que l’exercice a démontré et ce qui reste à tester : accès à la base, persistance, exposition externe et résilience en production.
Pour supprimer uniquement ces trois objets d’exercice :
kubectl --context coffee-workload -n coffee-demo delete -f workload.yamlLe namespace reste alloué. L’exemple n’a pas de PVC et ne contient aucune donnée métier. Si tu as adapté le fichier, vérifie précisément ce que la suppression va enlever.
Continue avec la maintenance et la reprise au quotidien, avec la même réponse du menu comme contrôle avant et après. Le parcours va des bases réseau au déploiement, puis au day 2 et au GitOps avec Argo CD.
Reçois le prochain par email
Les nouveaux articles et séries, envoyés à leur publication. Aucun autre courrier.