TOP pose sa tasse vide près d’un ticket de l’application interne Pause Café : le bouton de réapprovisionnement renvoie une erreur. Le point café est à sec. Il ouvre l’application sur son portable et prend l’incident en charge : distinguer la lecture du menu de la commande durable, puis localiser le début de la panne.
À l’accueil, un collègue lui montre Pause Café, une application interne pour consulter le menu et demander le réapprovisionnement d’un point café. TOP découvre que le stock de grains est nul et que le bouton de commande renvoie une erreur. Sa première question : « Quel chemin applicatif cette action emprunte-t-elle ? »
C’est le point de départ de cette série VKS révisée en cinq épisodes. TOP Dev part des besoins du logiciel et s’appuie sur sa connaissance de l’infrastructure pour expliquer ce qui se passe quand une application quitte l’ordinateur de son développeur. Comme dans Ça marche sur ma machine, nous partons d’une requête utile ; cette fois, Pause Café fournit le fil rouge. L’application interne existe déjà : les exercices isolent ses mécanismes, sans construire toute une plateforme pendant le traitement de cet incident. L’objectif est d’obtenir un service fonctionnel, observable et dont les responsables sont identifiés.
Cet article a été largement révisé le 27 octobre 2026. Il porte sur la famille VCF 9 et sur vSphere Kubernetes Service, abrégé VKS. Les API précises, les versions prises en charge et les interfaces de consommation dépendent de l’environnement installé. Les exemples sont des exercices expliqués ; ils ne prétendent pas décrire un déploiement réel de cette série sur une plateforme VKS.
Partir de la requête, puis représenter la plateforme
Pause Café a deux opérations distinctes : GET /menu lit le stock ; POST /orders enregistre une demande de réapprovisionnement. Une commande acceptée renvoie 201 Created et un identifiant que le front peut relire avec GET /orders/{id}. Les processus de l’API utilisent PostgreSQL partagé : remplacer un Pod ne doit pas faire disparaître l’historique. Une demande enregistrée n’augmente pas le stock physique et ne prépare pas le café.
Deux supports permettent d’observer ces mécanismes. Le fixture Kubernetes renvoie un menu constant, sans base ni écriture, pour isoler le trajet du Service. Le labo local Pause Café ajoute un front, une API et PostgreSQL. Nous y avons vérifié la création, la relecture, les tentatives répétées avec la même clé et la conservation d’une commande après redémarrage de l’application et passage en v2. Ce test local n’est pas une exécution sur VKS.
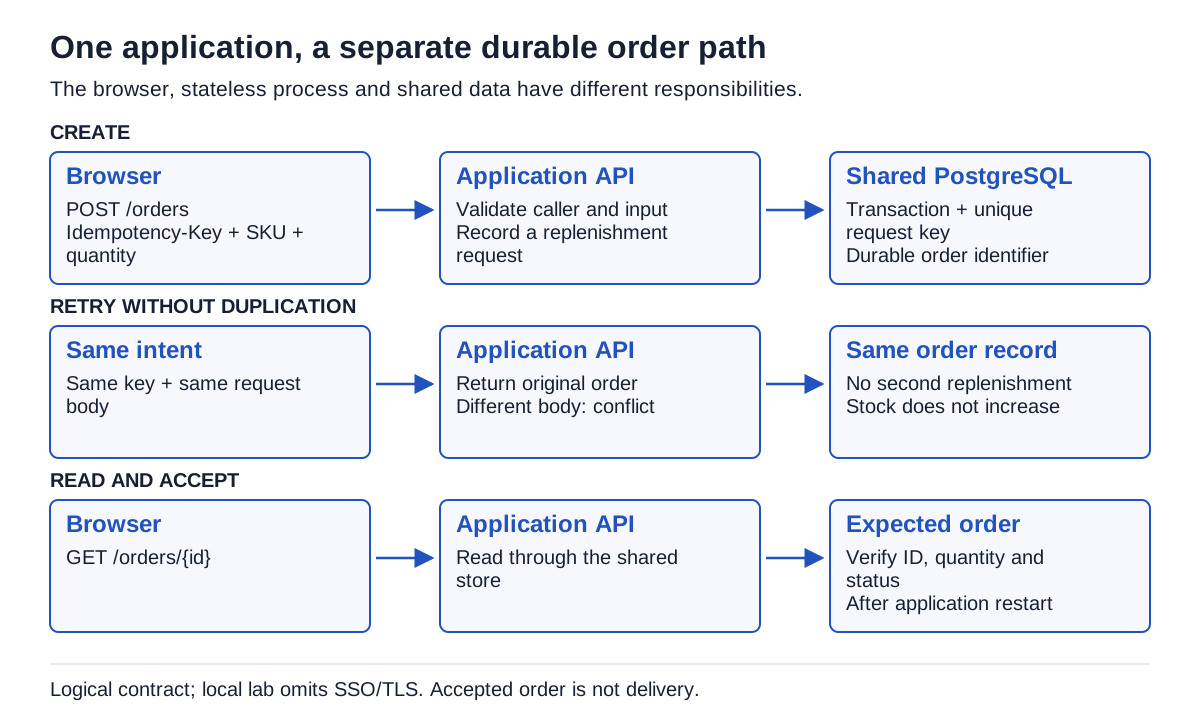
La commande, sa répétition et sa relecture forment un contrat vérifiable. Le labo local ne fournit pas de SSO ni de TLS ; en production, l’identité, les autorisations et la confiance doivent être fournies par le dispositif approuvé.
L’application a besoin d’une image, de sa configuration, de ressources et de chemins réseau utilisables. La production exige aussi une identité de base aux droits limités, un secret gardé hors de Git, sa rotation et un responsable de la restauration. Le labo initialise son schéma au démarrage ; il ne démontre pas un processus de migration ou de gestion des droits de production. Kubernetes peut exécuter le processus correctement alors que la commande échoue encore.
Avant de demander un cluster, TOP rédige un petit contrat d’exécution :
| Question | Exemple de menu | Preuve à recueillir |
|---|---|---|
| Que doit-on exécuter ? | Une image contrôlée et identifiée par son digest | Image réellement utilisée par le Pod |
| À quoi faut-il répondre ? | HTTP GET /menu et API de commande distincte |
Stock attendu et identifiant durable de commande |
| Quelles données persistent ? | Commandes et stock dans PostgreSQL partagé pour l’application de référence | Responsable, identité de base aux droits limités et procédure de restauration |
| Qui peut se connecter ? | Identité utilisateur et rôle applicatif dans la base | Opération autorisée avec l’identité prévue |
| Quelles ressources faut-il joindre ? | Registre, DNS, base de données et point d’entrée utilisateur | Tests depuis les contextes d’exécution concernés |
| Qui intervient en cas de panne ? | Équipe applicative avec une voie d’escalade vers la plateforme | Responsable nommé, alerte et données de diagnostic utiles |
Ce sont des exemples à décider ensemble, pas la configuration par défaut de VKS. Une entreprise peut fournir un cluster partagé et un namespace applicatif plutôt qu’un nouveau cluster à chaque équipe. Le contrat reste nécessaire.
Deux API Kubernetes, deux états souhaités
Le Supervisor expose la partie gestion utilisée pour provisionner les clusters de workloads VKS. Son control plane s’appuie sur des VM dédiées ; il ne s’agit pas simplement de l’API vCenter sous un autre nom. Broadcom décrit ces VM dans la KB 323407.
Le cluster de workloads possède sa propre API Kubernetes et son propre control plane. C’est là que notre équipe crée les Deployments, Services et ConfigMaps applicatifs. La santé de l’API des workloads et la disponibilité du service de gestion sont deux observations distinctes. Un incident du Supervisor ne signifie pas automatiquement que tous les processus applicatifs en cours se sont arrêtés ; les opérations de provisionnement et de cycle de vie affectées restent toutefois importantes.
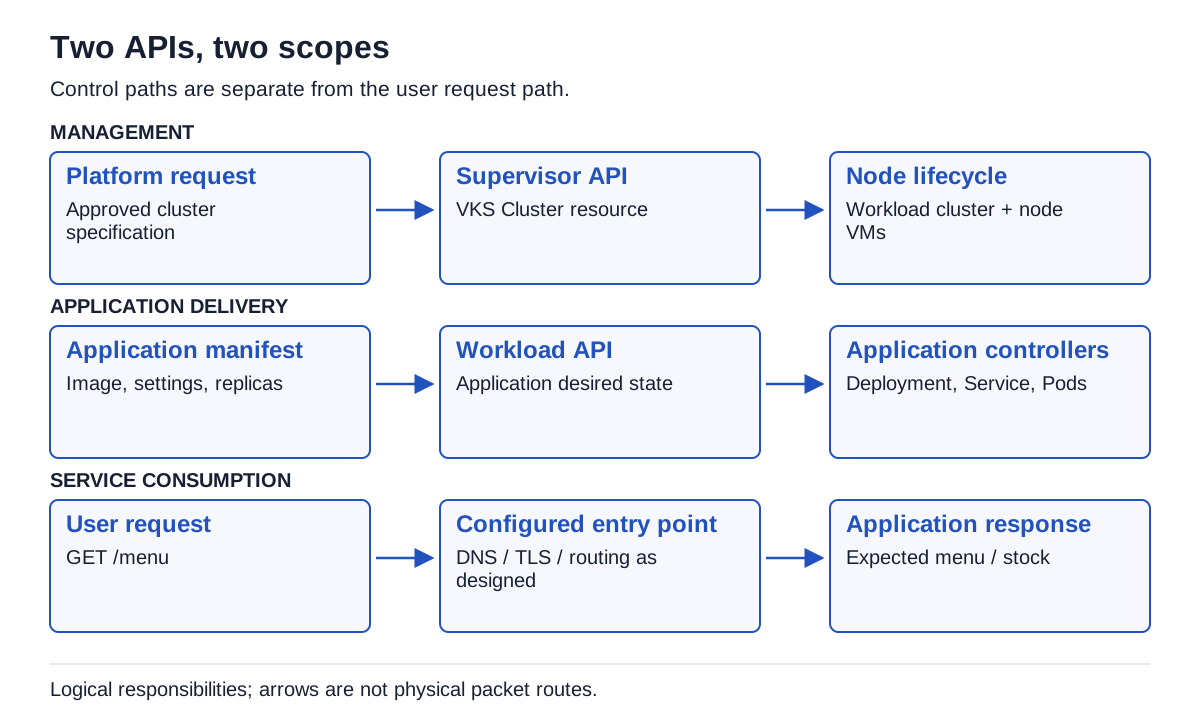
Deux chemins de contrôle et un chemin de requête applicative. Les flèches indiquent les responsabilités, pas le routage physique des paquets.
Une ressource Cluster sur le Supervisor décrit un cluster à réconcilier. Un Deployment dans ce cluster décrit les réplicas d’une application à réconcilier. Ce sont deux objets déclaratifs. Ils demandent à des contrôleurs différents, dans des périmètres différents, de produire des choses différentes. La présentation des composants Kubernetes explique les responsabilités de l’API des workloads, du scheduler et des nœuds.
Cette distinction permet de comprendre une erreur concrète : appliquer un manifeste applicatif tout en étant encore connecté au Supervisor. Un fichier YAML valide peut cibler le mauvais système. Note les deux contextes kubeconfig et indique explicitement le contexte dans les commandes. Un contexte est une configuration locale du client qui sélectionne un cluster et des identifiants ; son nom convivial ne prouve pas à lui seul quelle est la destination.
Au poste, TOP et son collègue décrivent le trajet de la commande et répartissent les responsabilités : l’équipe plateforme fournit le périmètre, l’équipe applicative précise le processus, ses droits et ses données. Le dessin devient une liste de questions vérifiables.
Un namespace a un périmètre, pas un sens universel
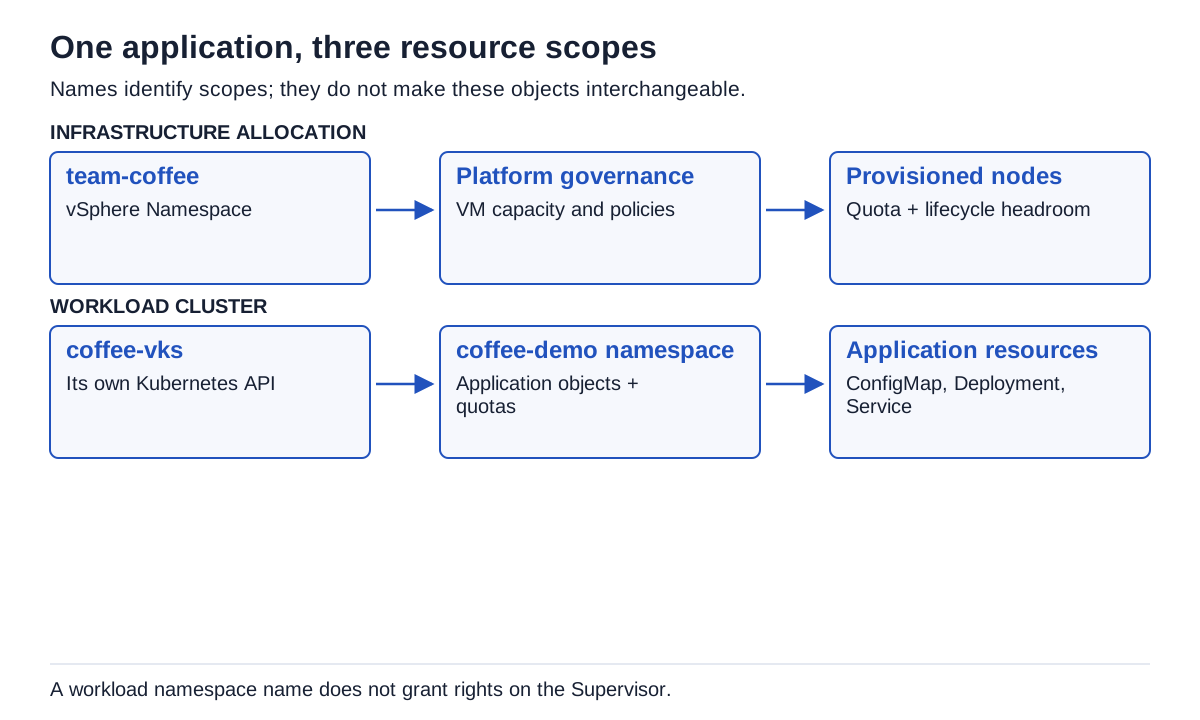
Côté gestion, un vSphere Namespace fournit à l’équipe un périmètre gouverné pour les ressources d’infrastructure qui lui sont allouées. Dans le cluster de workloads, un namespace Kubernetes regroupe des objets applicatifs limités à cet espace. Leur donner le même nom n’en ferait pas le même objet.
Pour ce parcours, nous appelons team-coffee l’allocation de gestion et coffee-demo le namespace temporaire de l’exercice applicatif. Le cluster de workloads s’appelle coffee-vks. Ces noms sont volontairement différents afin qu’une capture d’écran ou une commande ne brouille pas leurs rôles.
Un namespace ne répond pas à toutes les exigences d’isolation. Le niveau de séparation nécessaire dépend du RBAC Kubernetes, des politiques d’admission, de la sécurité des workloads, du réseau et de la confiance entre les équipes. Un cluster dédié peut se justifier ; un namespace séparé peut suffire à un autre service. L’équipe plateforme doit publier cette frontière au lieu de laisser les auteurs applicatifs la déduire du nom.
TOP demande deux enveloppes de ressources. La première couvre les VM des nœuds et la capacité de réserve pendant les opérations de cycle de vie. La seconde couvre les demandes et limites applicatives ainsi que les quotas du cluster de workloads. La mémoire libre visible sur un hôte ne prouve pas que l’une ou l’autre enveloppe accepte le prochain Pod ou le nœud de remplacement.
Traduire l’infrastructure familière en capacités applicatives
Le calcul, le stockage et le réseau sont toujours présents sous VKS. L’application consomme leurs capacités publiées par l’intermédiaire d’objets Kubernetes et d’interfaces de plateforme. C’est dans cette traduction que la collaboration devient concrète.
Un registre d’images stocke l’artefact exécutable. Le runtime doit pouvoir le joindre et lui faire confiance ; réussir à télécharger l’image depuis l’ordinateur de l’administrateur ne prouve pas que les nœuds peuvent le faire. Un ConfigMap peut contenir des paramètres non sensibles. Pour un Secret Kubernetes, il faut convenir d’un modèle de protection et de distribution : son nom ne rend pas l’identifiant applicatif disponible ni correct.
Pour les données persistantes, une PersistentVolumeClaim demande du stockage par l’intermédiaire d’une StorageClass. Le cycle de vie des données de l’application doit tenir compte du système sous-jacent et de la politique de récupération. Supprimer puis recréer un Pod n’équivaut pas à restaurer ses données. Voir les volumes persistants.
Pour l’exposition réseau, un Service fournit une abstraction de service Kubernetes. L’accès externe exige un mécanisme d’exposition pris en charge par la plateforme et, le cas échéant, un dispositif de routage HTTP, de DNS et de certificats. VKS ne donne pas une URL publique à chaque application simplement parce que son Pod est à l’état Running. Les types de Service décrivent la partie Kubernetes ; il faut identifier le fournisseur réellement configuré dans l’environnement.
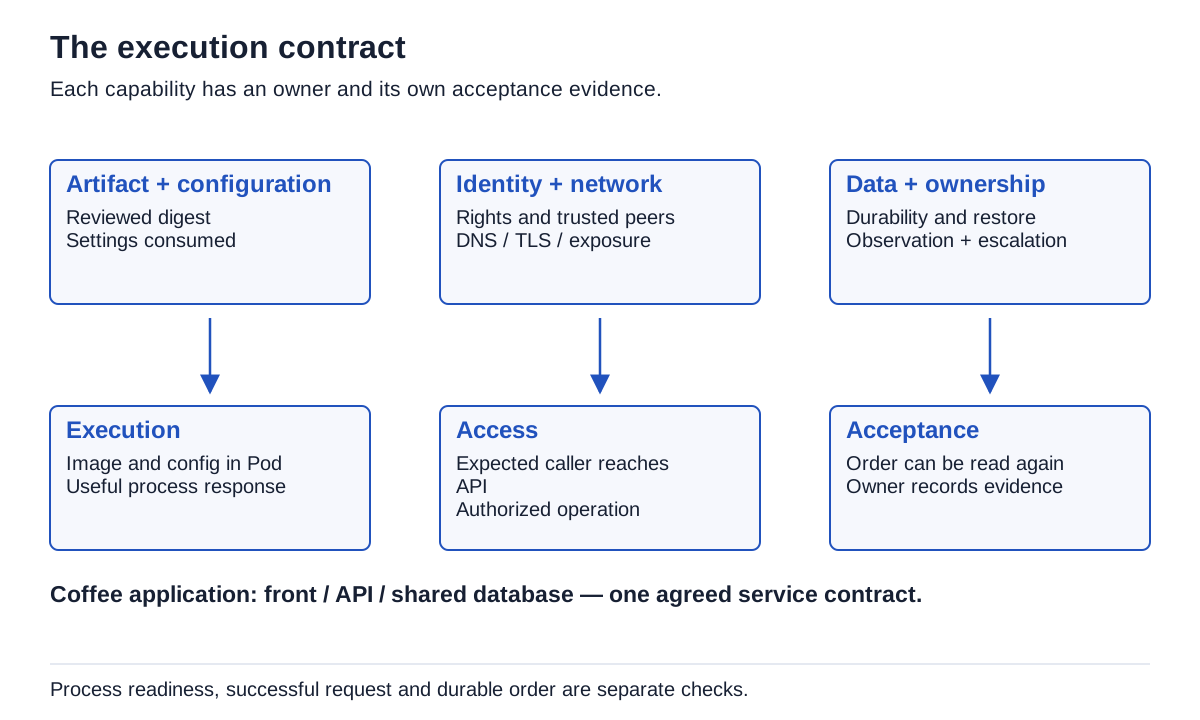
Chaque capacité a un responsable et un contrôle de recette. Il s’agit d’un contrat de service, pas d’une nomenclature produit.
Choisir un mode de consommation sans changer les responsabilités
La plateforme peut proposer la création approuvée d’un cluster par portail, catalogue ou workflow Kubernetes/API. VCF Automation peut ajouter une gouvernance organisationnelle et du libre-service. D’autres environnements exposent directement un workflow Supervisor pris en charge. Utilise l’interface exploitée et prise en charge par ta plateforme, avec son modèle approuvé et son modèle d’identité. Guide de gestion VKS.
Le résultat important est concret : endpoint cible, identifiants émis, namespace alloué, version prise en charge, modèle d’exposition réseau, capacités de stockage et responsable du support. Le nombre de clics ne remplace pas cette transmission. Un manifeste généré mérite d’être relu ; le fait qu’il ait été généré ne garantit pas que son dimensionnement ou ses politiques conviennent à la production.
Distingue les trois niveaux avant de choisir les versions :
| Niveau | Ce que l’on relève | Ce qu’il faut vérifier |
|---|---|---|
| Plateforme et Supervisor | Version réellement installée | Compatibilité du service VKS et des composants de gestion |
| Service VKS | Version du service installé | Versions Kubernetes offertes et conditions du parcours |
| Cluster de workloads | Version Kubernetes actuelle et cible | Combinaisons prises en charge et extensions compatibles |
Leurs cycles de vie peuvent être séparés dans les combinaisons prises en charge. Avant un changement, consulte la matrice d’interopérabilité et les notes de version pour les versions source et cible réelles. Le parcours de compatibilité Broadcom explicite ce prérequis.
Ce parcours se concentre sur l’architecture nécessaire au service Pause Café. Concevoir une mise à niveau produit exige toujours une évaluation propre à la version ; un parcours applicatif ne peut pas la remplacer.
La transmission qui nous permet de continuer
Avant de poursuivre, TOP vérifie que l’équipe sait identifier les deux endpoints d’API, expliquer les identités utilisées, localiser les namespaces alloués et décrire une requête utile. Il demande aussi ce qui se passe si le processus applicatif actuel disparaît : quel contrôleur le remplace, d’où vient sa configuration et où restent ses données.
Une fois le service déployé, nous répéterons la même requête depuis le parcours utilisateur prévu et avec les permissions attendues. Nous comparerons l’image et la configuration réelles au contrat. Nous conserverons ces contrôles pendant la maintenance et le déploiement GitOps, au lieu de les inventer à la fin.
En quittant le point café, TOP reprend avec son collègue les questions notées dans son carnet : le menu répond, la commande échoue. Ils conviennent de qui vérifiera chaque étape entre les API et la base, avant de poursuivre le diagnostic dans VKS.
TOP dispose maintenant d’un contrat concret : lire le menu, authentifier la personne, soumettre une commande de réapprovisionnement et conserver son identifiant dans PostgreSQL. Une réponse GET statique ne prouve pas ce chemin d’écriture. Suis le parcours réseau : Service, endpoints prêts, point d’entrée externe et chemin de retour. Les contrôles du parcours permettront d’identifier la couche à examiner.
Reçois le prochain par email
Les nouveaux articles et séries, envoyés à leur publication. Aucun autre courrier.