Au point café, une collègue montre à TOP la commande qui échoue depuis son téléphone. Le menu interne affiche bien un stock de grains nul ; le bouton de réapprovisionnement ne fonctionne toujours pas. TOP note le contexte de cette requête avant de la suivre via DNS et le Service, puis de vérifier si l’API peut joindre PostgreSQL.
Avant de conclure que l’application se trompe, il faut suivre la requête : le bon nom, la bonne destination, un backend prêt et une réponse que l’on sait interpréter.
Dans le premier épisode, nous avons distingué l’API de gestion du cluster de workloads. Suivons maintenant GET /menu jusqu’à l’application de ce cluster. TOP Dev suit le comportement de l’application et le relie aux preuves d’infrastructure.
Révisé le 27 octobre 2026, cet article distingue les concepts Kubernetes courants de la conception réseau VKS réellement installée. Un environnement appuyé sur NSX/VPC et un environnement appuyé sur VDS nécessitent chacun une topologie prise en charge. Les commandes d’exercice visent un namespace de workloads temporaire décrit dans l’épisode suivant ; elles ne servent pas à modifier un réseau de production.
Consigner le point de départ sur le résultat du test
« Pause Café fonctionne depuis mon ordinateur » ne constitue pas une preuve complète. Quelle adresse, quel port, quel protocole et quel chemin l’ordinateur a-t-il utilisés ? La requête a-t-elle traversé la passerelle externe, utilisé port-forward ou atteint directement un Pod ? Le certificat TLS a-t-il été vérifié ? Chaque réponse modifie ce que le succès permet de conclure.
TOP consigne l’environnement source, le nom de destination, l’adresse résolue, le port, la version du menu et la réponse. Il utilise deux chemins : une requête exécutée dans le cluster applicatif et une autre depuis le réseau prévu pour les utilisateurs. Elles répondent à des questions différentes.
| Observation | Prochaine vérification utile |
|---|---|
| Le nom ne se résout pas | Résolveur utilisé, domaine de recherche, enregistrement DNS et trafic DNS autorisé |
| Le nom se résout, mais TCP expire | Destination réelle, route, filtrage, chemin retour et santé du service |
| La vérification TLS échoue | Chaîne de certificats, nom, confiance et point réel de terminaison |
| HTTP 404 | Routage de l’hôte et du chemin, et gestionnaire qui reçoit la requête |
| HTTP 503 | Composant qui a renvoyé le code et dépendance amont indisponible |
| HTTP 200 avec la mauvaise liste | Version réellement déployée, cible de la requête, configuration et source des données |
Un délai d’attente n’identifie pas à lui seul un pare-feu. Un code HTTP ne permet pas non plus d’identifier qui l’a émis. Avant de modifier les règles, conserve la réponse et les journaux pertinents. Le guide Kubernetes de débogage DNS aide à déterminer le résolveur et le nom concernés.
Un Service a besoin de destinations correspondantes et utilisables
Dans notre cluster de workloads, le Service coffee sélectionne les Pods étiquetés app: coffee. Kubernetes consigne les endpoints de backend dans des EndpointSlices. L’état Ready détermine si un backend peut normalement recevoir le trafic du Service. Il faut donc relier trois observations : sélecteur et port du Service, étiquettes et état Ready des Pods, puis endpoints publiés. Déboguer les Services.
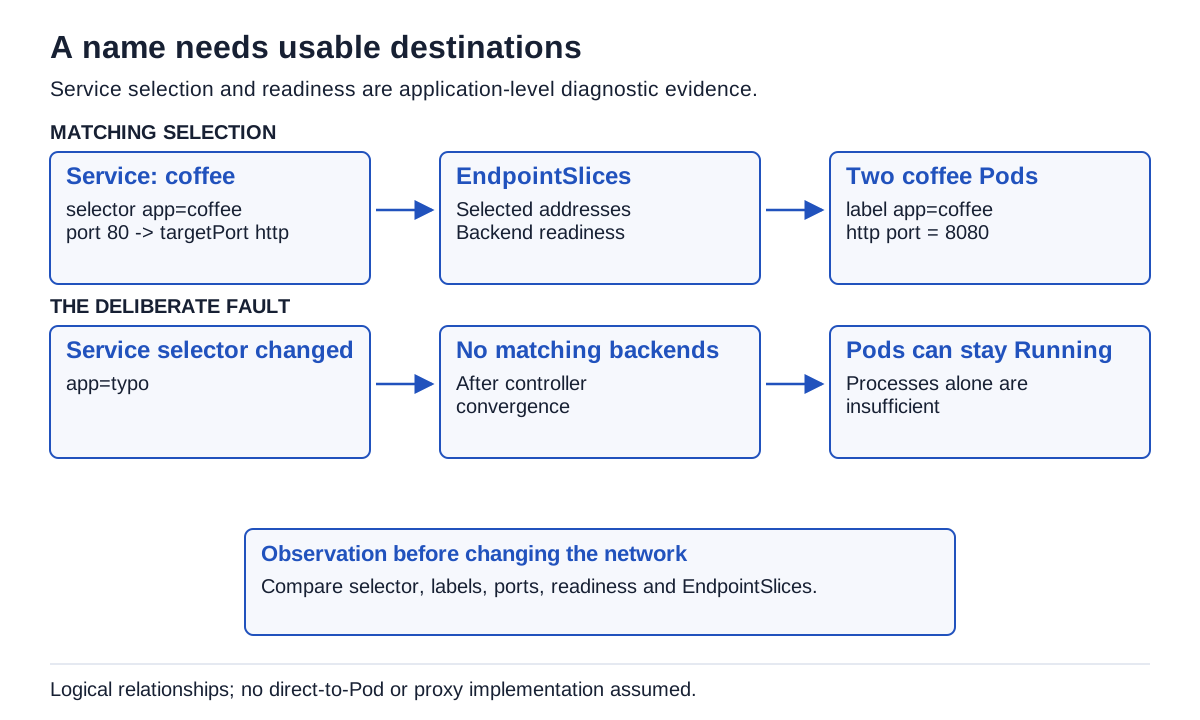
Sélection logique et découverte des endpoints. Le schéma ne prescrit ni proxy, ni implémentation CNI, ni route physique.
Avec l’exemple temporaire installé et le contexte kubeconfig nommé coffee-workload :
kubectl --context coffee-workload -n coffee-demo get service coffee -o yaml
kubectl --context coffee-workload -n coffee-demo get pods -l app=coffee --show-labels
kubectl --context coffee-workload -n coffee-demo get endpointslices -l kubernetes.io/service-name=coffee -o yaml
Vérifie ensemble port, targetPort, les étiquettes, les adresses des endpoints et leur état Ready. Un Pod à l’état Running peut ne pas être prêt. Le processus sélectionné peut écouter sur un autre port. Un Service sans destination adaptée ne peut pas fabriquer une réponse applicative.
Dans le petit exercice, cet appel est exécuté dans un Pod applicatif existant et utilise le nom interne du Service :
kubectl --context coffee-workload -n coffee-demo exec deployment/coffee -- wget -qO- http://coffee/menuLe résultat attendu liste coffee-beans avec un stock de 0 et filters avec un stock de 24. L’image inclut wget, mais ce n’est pas forcément le cas d’une autre image applicative. Ton rôle doit autoriser la commande exec. Les politiques peuvent traiter différemment un Pod de diagnostic ayant d’autres étiquettes ou une autre identité : décris son contexte au lieu de supposer qu’il équivaut à celui de l’application.
Devant le tableau de diagnostic, TOP et son collègue relient leurs observations au trajet de la requête : résolution DNS, selector du Service et EndpointSlices. Une ligne est barrée dans le carnet : ce contrôle-là est passé. Il reste à identifier le saut qui échoue.
L’accès externe ajoute un dispositif distinct
Un Service ClusterIP est une abstraction interne. Pour les utilisateurs hors du cluster, la plateforme fournit un mécanisme d’exposition approuvé. Un Service de type LoadBalancer délègue le provisionnement à l’intégration installée. Le routage HTTP par hôte ou chemin nécessite une passerelle ou une solution ingress effectivement déployée. Créer un objet d’API n’installe pas le contrôleur qui doit le prendre en charge. Types de Service Kubernetes.
L’ancien article présentait Avi/AKO, T0/T1 et le routage direct vers les Pods comme une séquence obligatoire. C’est trop général. Identifie le fournisseur de load balancing réel et son mode de fonctionnement côté backend : le trafic peut être transféré vers des cibles au niveau des nœuds, vers une autre intégration prise en charge ou suivre le routage configuré par la plateforme. La présence de NSX ne prouve pas que chaque Pod est directement joignable.
Pour NSX/VPC, consigne le sous-réseau publié, la passerelle, l’allocation, l’exposition et les règles de sortie. Pour VDS, documente le réseau des workloads et le mécanisme de load balancing pris en charge. Dans les deux cas, le contrat applicatif doit toujours préciser adresses, ports, responsabilités et route de retour. Broadcom regroupe ces choix et politiques dans son guide réseau VKS.
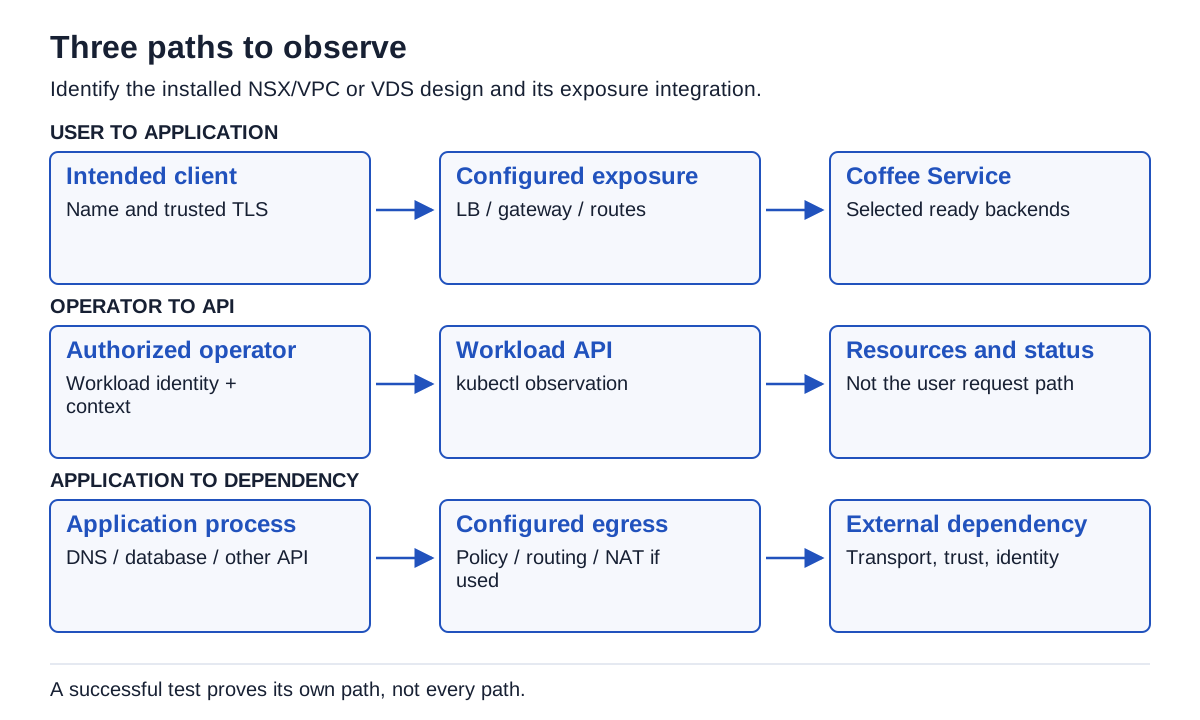
Les blocs marqués « configuré » signalent des points à vérifier dans ton environnement. Ils ne signifient pas que tous les déploiements VKS utilisent le même répartiteur de charge ou le même NAT.
Pour le test externe, utilise le véritable FQDN du service depuis le réseau client prévu. Vérifie HTTPS normalement, y compris avec son autorité de certification de confiance. Note où TLS se termine et si le saut suivant est chiffré. Un certificat valide sur la passerelle ne prouve rien sur la configuration de confiance de la base de données.
La requête sortante de l’application entame un autre parcours
Une version persistante de Pause Café pourrait, par exemple, appeler PostgreSQL sur TCP 5432. Cette connexion part de son environnement d’exécution, pas du navigateur de l’utilisateur. Son adresse source observée peut avoir été traduite. Demande à l’équipe réseau quelle adresse le pare-feu de la base voit réellement et comment la réponse revient.
Les adresses des nœuds, les CIDR des Pods, ceux des Services et les plages d’adresses externes ont des fonctions différentes. Réserve-les et valide-les dans le cadre de la conception réseau ; vérifie les chevauchements avec les réseaux d’entreprise joignables et le respect des règles de la plateforme. Ne transforme pas un CIDR d’exemple en plan d’allocation universel.
Une NetworkPolicy Kubernetes standard peut sélectionner les permissions d’entrée et de sortie si une implémentation réseau compatible l’applique. Les règles peuvent s’additionner ; si l’entrée ou la sortie est isolée, le chemin concerné doit être autorisé dans les deux sens requis. Une NetworkPolicy ne peut pas annuler un refus dans un autre pare-feu. Voir les politiques réseau.
TOP part des besoins de l’application : DNS, destinations approuvées et ports. La plateforme les traduit en contrôles adaptés. Appliquer une politique de refus par défaut sans prévoir DNS et dépendances peut casser un processus parfaitement sain. À l’inverse, une politique qui autorise tout masque les flux réellement nécessaires au service.
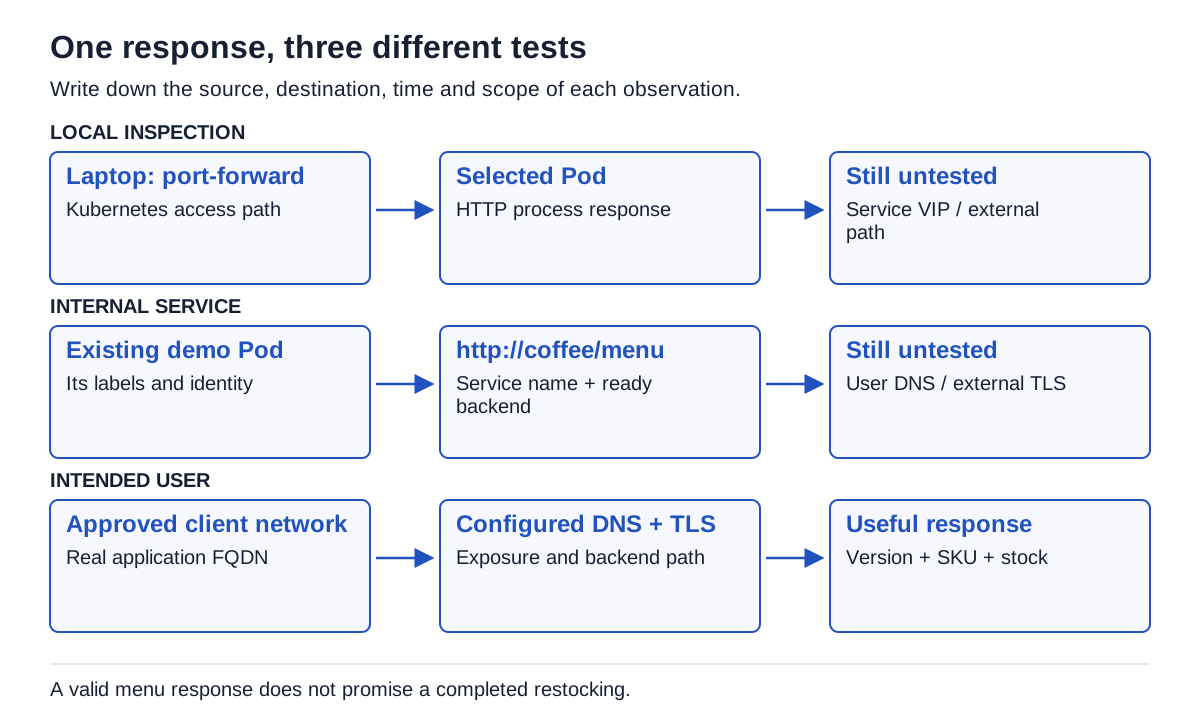
Tenir une fiche de recette réseau avant/après
Avant l’exposition ou un changement réseau, consigne le sélecteur et les ports du Service, les endpoints prêts, la version de l’image, le comportement DNS/TLS attendu et une réponse de menu réussie. Si cette dépendance existe, consigne aussi le test entre l’application et la base de données. L’exemple statique de l’exercice n’a délibérément pas de base ; son succès ne prouve rien sur cette dépendance.
Après le changement, répète les mêmes requêtes depuis les mêmes points. Compare le contenu de la réponse autant que son statut. Si l’accès interne fonctionne mais que l’accès externe échoue, examine le dispositif externe avec son responsable. Si les endpoints internes disparaissent, commence par les étiquettes et l’état Ready avant de demander un changement BGP.
Port-forward est utile pour examiner un processus applicatif sélectionné, mais contourne plusieurs étapes du parcours normal du Service. Considère son succès comme une preuve limitée à ce chemin. Dans l’épisode suivant, nous modifierons volontairement le sélecteur du Service de démonstration, constaterons l’absence de backends puis le rétablirons. Le nombre de Pods restera rassurantement inchangé pendant toute la panne.
Près du meuble de stockage, son collègue lui montre le bocal vide : le stock nul du menu est cohérent, mais il faut encore pouvoir commander. TOP garde une question réseau précise dans son carnet : quel saut entre le navigateur, le Service de l’API et PostgreSQL est en panne ?
Poursuis avec le premier cluster et la première application. Nous garderons les deux contextes explicites et ferons fonctionner un petit service avant d’ajouter une adresse publique ou une base de données.
Reçois le prochain par email
Les nouveaux articles et séries, envoyés à leur publication. Aucun autre courrier.