Le portail est passé en VCF Automation 9.1.1, mais les équipes commandent encore des VM depuis les mêmes formulaires et les mêmes contrats de service. TOP refuse le grand soir : l’organisation VM Apps continue de servir pendant que l’équipe reconstruit une offre All Apps, puis la fait tester par un petit groupe.
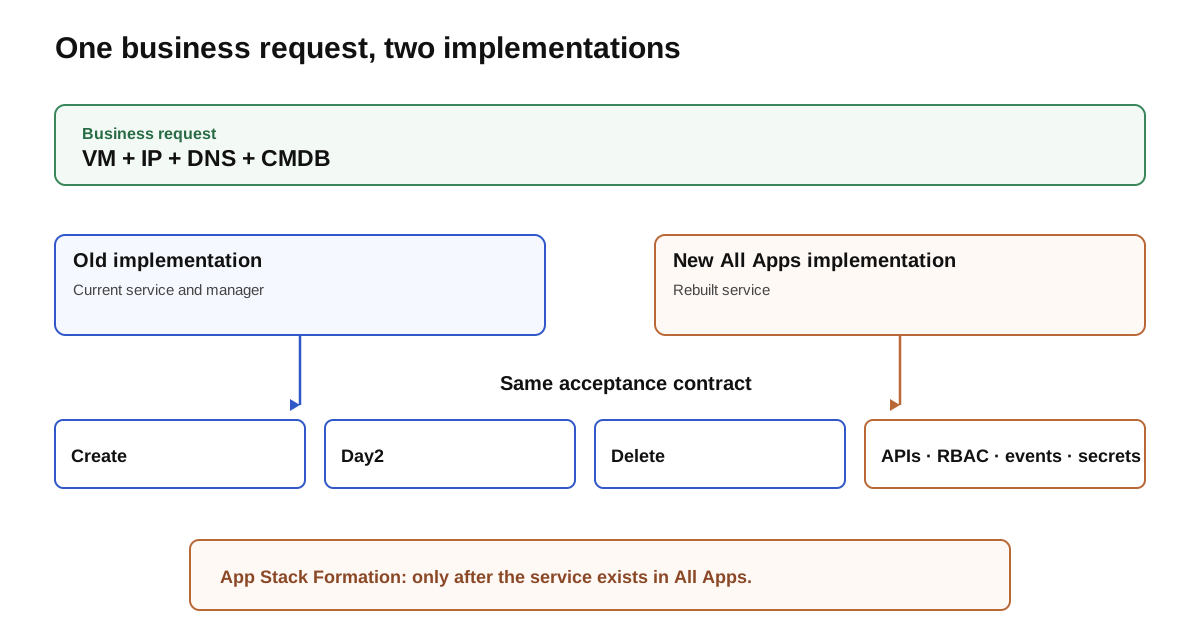
Le fil rouge est un service concret : VM + IP + DNS + CMDB. On va décider ce qui reste en place, ce qu’il faut réécrire, comment router les demandes vers une nouvelle implémentation, et quelles preuves permettront d’autoriser le retrait de l’ancien service. C’est un plan opératoire à adapter et à tester, pas le récit d’une migration exécutée.
Sources consultées le 25 octobre 2026. Les capacités de la famille 9.1 sont à qualifier sur le build 9.1.1 retenu, avec leurs prérequis et droits. Aucune exécution terrain ni performance garantie n’est revendiquée.
TL;DR
- Garder l’existant en service après l’upgrade et construire chaque remplacement All Apps à côté, avec un contrat de recette commun.
- Ne pas confondre coexistence et conversion. Les déploiements historiques restent gérés par leur modèle d’origine ; aucun convertisseur ne les transfère automatiquement.
- Lundi matin : choisir un service peu risqué, relever ses consommateurs et tester create, Day2, delete et nettoyage avant d’ouvrir un pilote.
Une plateforme bimodale, deux voies de gestion
VCF Automation 9.1 documente un modèle bimodal : VM Apps et All Apps peuvent partager le même vCenter et NSX Local Manager. Cette option de Mixed Tenancy Mode exige notamment un Supervisor avec VPC Networking. Pour une paire vCenter/NSX partagée, l’organisation VM Apps doit être entièrement configurée — cloud accounts vCenter et NSX inclus — avant la Region All Apps. Les KB 444058 et 443541 décrivent cet ordre et les erreurs possibles si on le renverse. Le design partagé Broadcom présente cette architecture comme un choix à qualifier.
Partager la paire ne transforme pas l’organisation, ne fusionne pas les tenants et ne donne pas deux gestionnaires au même déploiement. Une infrastructure All Apps dédiée est une autre option d’architecture, si le coût et la séparation de management le justifient. Ce n’est pas un bouton de conversion. Pour les workloads qui restent dans VM Apps, les actions et la responsabilité opérationnelle restent sur leur voie actuelle.
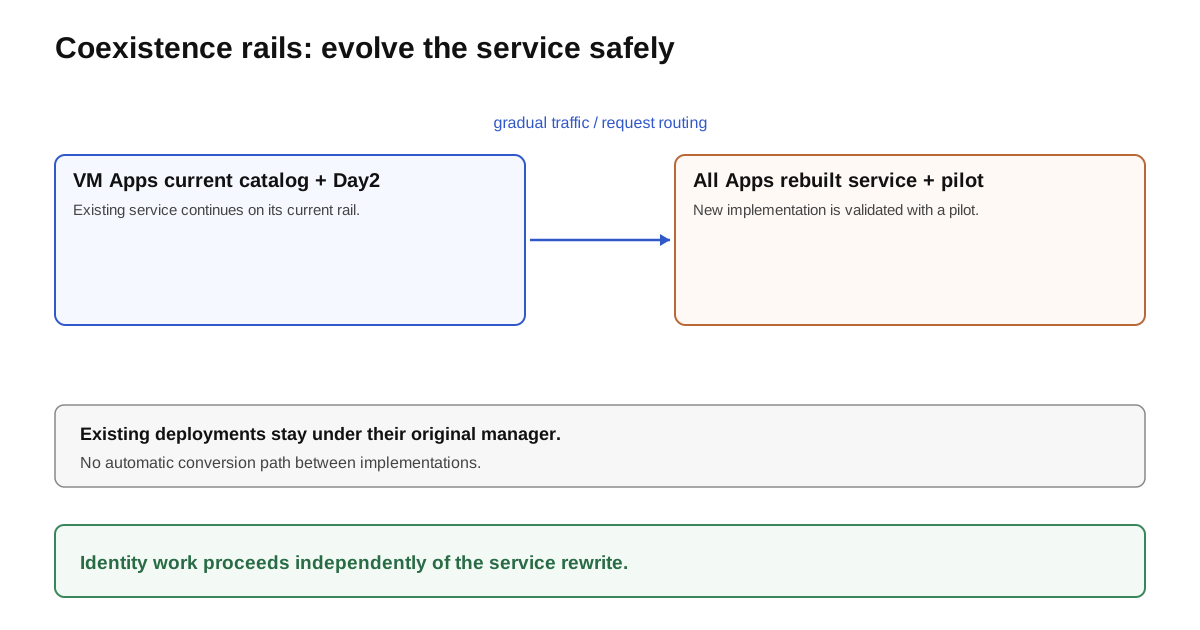
Une migration d’identité n’est pas une étape implicite de cette réécriture. Le chantier d’identité VM Apps est séparé : épisode dédié à la migration d’identité. Garder deux voies de service ne décide pas quel fournisseur d’identité doit être utilisé ni quand le tenant VM Apps bascule.
Définir le contrat avant de réécrire
Le ticket « créer une VM » cache plusieurs engagements : allouer une adresse, créer ou mettre à jour un enregistrement DNS, inscrire le propriétaire dans la CMDB, exposer l’état, renouveler ou modifier le service, puis tout nettoyer à la suppression. Le nom du catalogue n’est pas le contrat. Le contrat décrit le résultat attendu et les preuves de réussite, indépendamment de l’outil qui l’implémente.
| Élément VM Apps à inventorier | Équivalent ou décision All Apps | Preuve à exiger |
|---|---|---|
| Cloud Template et profils | API et objets Supervisor ; classes, image, stockage et réseau adaptés | Le placement et les entrées produisent le résultat attendu |
| Formulaire personnalisé | Schéma d’API et expérience de demande | Les mêmes choix métier sont validés côté serveur |
| ABX, EBS ou workflow Orchestrator | Intégration ou service externe explicite | Erreurs, répétitions et délais sont maîtrisés |
| Actions Day2 et droits | Opérations d’API, RBAC et politiques | Le bon persona peut agir, et les autres sont refusés |
| Notifications et événements | Topics d’événements All Apps et consommateur adapté | Les événements déclenchent des traitements idempotents ; ils ne remplacent pas une transaction |
| IPAM, DNS, CMDB, secrets | Contrats d’intégration et identifiants gérés | Création, mise à jour, reprise et nettoyage sont traçables |
Ce tableau révèle des écarts ; il ne promet aucune correspondance objet pour objet. Ne présumez pas que YAML, abonnements ou extensions se copient sans changement. Les topics d’événements IaaS All Apps donnent des signaux, pas des transactions : rendez les consommateurs idempotents et vérifiez leur comportement sur le build cible.
Construire une verticale, pas un catalogue entier
Pour le pilote, TOP choisit une classe de VM interne peu critique, un réseau VPC, une image approuvée et un sous-réseau où l’allocation d’adresse est maîtrisée. L’équipe configure la Region, ses quotas et limites, puis crée un Namespace avec le contrat de ressources attendu : VM Service, classes de VM, images de Content Library, stockage et réseau. Elle teste le cycle du service au travers des API et rôles réellement prévus.
La réécriture n’oblige pas à déplacer chaque brique vers Kubernetes. Une VM reste pertinente lorsque le service dépend d’un système d’exploitation ou d’un logiciel qui en a besoin. VKS ou Container Service n’entre dans le design que si le service gagne réellement à être exécuté comme conteneur ; ce choix ajoute ses propres compétences, opérations et contrôles.
Regroupez les capacités par valeur de service : VPC Networking et IPAM pour le réseau ; quotas et politiques de Region pour la gouvernance ; bibliothèques de contenu et VM Groups pour les images ; API/Terraform pour l’intégration ; secrets pour les identifiants. La présentation VCF 9.1 recense les nouveautés ; retenez celles qui répondent à un besoin testable et ont un owner.
Voici notre grille de qualification des nouvelles façons de faire. Une capacité n’entre dans le service qu’après un test et une décision du responsable ; son apparition dans une présentation ne suffit pas.
| Capacité à qualifier | Ce qui change dans notre service | Recette à ajouter |
|---|---|---|
| VM Service, VKS, Container Service | Choisir le runtime selon le besoin applicatif | Exploitation, mise à jour et suppression par le bon persona |
| VPC, IPAM et connectivité | Définir une frontière réseau et ses routes explicites | Allocation/libération IP, DNS, filtrage et absence de chevauchement |
| Bibliothèque projet, VM Groups | Versionner images et groupes de VM | Publication autorisée, démarrage et arrêt cohérents |
| Fast Deploy | Qualifier le chemin de provisionnement des images | Mesurer le délai et vérifier disques et opérations ultérieures |
| Quotas, policies, prix estimé | Exprimer droits, limites et visibilité du coût | Refus hors quota, approbation, bail et estimation compréhensible |
| API/Terraform et secrets | Versionner contrats et paramètres sans embarquer les secrets | Réexécution, rotation et accès minimaux |
App Stack Formation peut aider à capturer un service une fois qu’il existe déjà dans un Namespace All Apps admissible. Ce n’est pas un convertisseur de Cloud Template VM Apps. D’abord déployer et valider l’application sur la voie All Apps, ensuite étudier la capture et relire le blueprint généré, conformément au guide de capture d’un Namespace. Les articles sur Mixed Tenancy, la migration des Cloud Templates et extensions et App Stack Formation détaillent ces sujets.
Router les consommateurs avec un retour possible
Le pilote commence par une liste nominative de consommateurs : équipe, formulaire ou API, version d’intégration, environnement et propriétaire. On choisit ensuite une vague courte et réversible. Le routeur de demandes, la documentation et le support indiquent clairement quelle implémentation reçoit une nouvelle demande. Les anciennes commandes restent disponibles aux consommateurs pas encore migrés.
Un registre de correspondance relie la demande source à la ressource cible : sourceRequest → targetDeploymentID, avec propriétaire, état de migration et liens vers les enregistrements IPAM, DNS et CMDB. Il facilite le support et empêche de confondre une VM existante avec sa remplaçante. Ne donnez pas simultanément la même adresse IP à deux VM, et n’autorisez pas deux writers sur la même base applicative. La bascule de données doit avoir son propre propriétaire et son propre protocole.
Pour chaque vague, gardez les actions Day2, la gestion des baux, les retries et le nettoyage du système source jusqu’à ce que ses consommateurs et ressources aient été migrés ou explicitement retirés. Si la nouvelle voie a déjà accepté des écritures, revenir au routage précédent ne remet pas les données en arrière : il faut décider comment synchroniser, réconcilier ou restaurer avant d’autoriser le rollback.
Go/no-go avant et après une vague
| Avant — autoriser seulement si… | Après — poursuivre seulement si… |
|---|---|
| Le contrat et les consommateurs de la vague sont connus | Les demandes réussies ont les preuves attendues |
| Les capacités, quotas, images et permissions sont prêtes | Day2, retries et suppression fonctionnent selon le contrat |
| La recette crée, modifie et supprime sans effet résiduel | IPAM, DNS et CMDB correspondent à l’état réel |
| Un chemin de retour est écrit, avec décision sur la donnée | Les erreurs, doublons et ressources orphelines sont expliqués |
| Les owners plateforme, service et données sont joignables | Les owners acceptent la vague suivante ou demandent une pause |
Pièges et points de vigilance
Le catalogue répond, mais le service n’est pas prêt
Un formulaire qui affiche le nouveau produit ne prouve ni que les rôles sont corrects, ni que DNS et CMDB se mettent à jour, ni que le nettoyage fonctionne. Évitez aussi les mutations simultanées : même adresse, même enregistrement ou mêmes données modifiés par deux voies peuvent produire un état impossible à réconcilier.
Le retrait est une décision ultérieure, avec ses propres prérequis : inventaire complet des consommateurs et déploiements, migration acceptée de l’identité et des clients concernés, répétition de restauration, arrêt réversible avec observation, archivage lisible et autorisation des owners. vIDM et Aria Suite Lifecycle ont des dépendances de retrait distinctes ; aucune condition ne se déduit du succès d’un service All Apps.
Conclusion
TOP n’organise pas une bascule unique de catalogue. Il protège la voie qui sert les déploiements existants et introduit les nouveaux services par contrat, test et vague de consommateurs. Chaque service retiré doit avoir une destination, une preuve de fonctionnement, un owner et une stratégie de données claire.
La continuité est explicite. Les déploiements source restent gérés sur VM Apps.
Le contrat guide la réécriture. Create, Day2, delete et dépendances comptent ensemble.
Le retrait exige une décision. La fin d’un pilote ne vaut pas autorisation de supprimer l’ancien.
Merci à Alina Thylander pour la présentation des capacités VCF 9.1, aux auteurs Broadcom des procédures liées et aux contributeurs de la documentation. Les schémas, le contrat VM/IP/DNS/CMDB et les checklists de transition sont nos propositions originales.
Reçois le prochain par email
Les nouveaux articles et séries, envoyés à leur publication. Aucun autre courrier.