La nouvelle salle de contrôle allume son voyant vert. TOP s’apprête à ranger les anciennes clés, puis aperçoit un colis immobile sur le comptoir. « La lumière fonctionne. Est-ce que la commande arrive vraiment ? »
Nous avons dessiné les réseaux, puis choisi le parcours et préparé les contrôles. Nous allons maintenant suivre la bascule, comprendre où commence l’indisponibilité et réunir les preuves nécessaires pour rouvrir le service.
Notre exemple reste une plateforme fictive avec catalogue de VM, IPAM, DNS et workflow d’enregistrement. Les sources ont été consultées le 25 octobre 2026 ; aucun upgrade de production ou de laboratoire n’est revendiqué ici. Le récit de transfert des données concerne la migration depuis l’ancienne architecture. Une plateforme déjà en 9.1.0.x suit son parcours de patch, pas un transfert de disque à reproduire manuellement.
La fenêtre a besoin d’un pilote et d’une sortie
- Fermer les nouvelles demandesPréserver une référence stable et une sauvegarde.
- Suivre l’opération supportéeObserver les tâches, sans réorchestrer leurs étapes à la main.
- Prouver le serviceRéseau, identité, demande complète et sauvegarde de la cible.
Avant de démarrer, le responsable du changement connaît la durée disponible, l’heure limite de décision et le temps réservé à une récupération. La durée d’un autre blog n’est pas une durée garantie pour ton volume de données. Les cinq dernières minutes d’une fenêtre ne suffisent pas à inventer le retour arrière.
Gèle les nouvelles demandes et les automates qui en soumettent. Termine ou traite explicitement les tâches déjà engagées, relève leur état et informe les consommateurs du service. Cela évite de confondre une requête envoyée pendant le gel avec une régression de la cible. Conserve les preuves de référence et les accès de secours hors de la plateforme que tu vas arrêter.
Exécuter le plan, pas les souvenirs d’un ancien assistant
Dans VCF Operations, le parcours documenté passe par Build → Lifecycle → VCF Management → Upgrade. Pour une migration nécessitant des paramètres, Configure prépare le plan ; on relit le résumé, lance Run Prechecks, corrige les erreurs puis relance les contrôles avant Upgrade. Les tâches permettent de suivre la progression. Procédure officielle.
Pour le cas de patch 9.1.0.x, utilise la cible et les dépendances correspondantes, dont l’ordre décrit dans l’épisode précédent. Ne saisis pas à nouveau des IP comme si tu créais une migration depuis Aria. Le build affiché, la ligne de composant sélectionnée et le résultat des préchecks doivent correspondre au dossier approuvé.
Le journal d’intervention garde l’heure, le composant, l’ID de workflow, l’étape, son résultat et les décisions prises. Une tâche longue mérite une lecture de ses sous-tâches et de ses journaux avant une action. Un rafraîchissement de navigateur ne remplace pas l’état du workflow ; une erreur d’interface ne prouve pas que les services sont arrêtés.
Ce qui déménage sous le capot
Le deep dive de Mohammed Aakhil décrit, pour Aria 8.18.x vers 9.1, un export sur Hard disk 2, un transfert de ce disque vers la cible après arrêt de la source, puis sa restitution et le nettoyage. Ce disque sert au passage des données ; ce n’est pas un stockage que l’opérateur doit détacher à l’initiative de ce tutoriel. Le détail exact de l’orchestration 9.1.1 reste celui du workflow et de sa documentation.
Le nom « blue-green » décrit le provisionnement d’une nouvelle cible avant la bascule. Il ne garantit pas une migration sans interruption. Dans le récit technique, les services de la source sont arrêtés avant l’extinction complète des VM. L’indisponibilité ressentie par l’utilisateur peut donc commencer avant la tâche d’arrêt des machines. Pour mesurer la coupure, utilise l’accès au service et les horodatages des tâches, pas seulement les événements Power Off de vCenter.
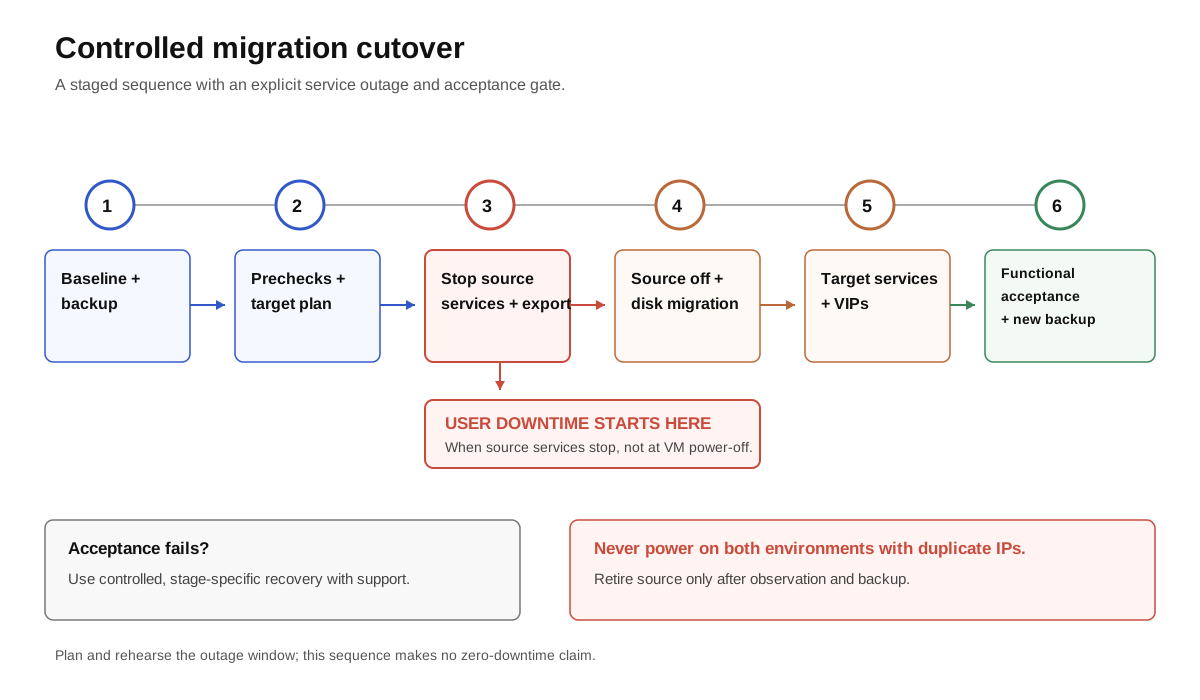
Chronologie logique de la migration depuis l’ancienne architecture. Les étapes détaillées et la récupération dépendent du build et de l’état atteint. Ce schéma n’est pas une séquence de commandes manuelles.
L’arrêt d’Automation ne signifie pas que toutes les VM déjà provisionnées sont éteintes. Il rend toutefois indisponibles certaines opérations de contrôle et peut affecter les consommateurs qui en dépendent. Cartographie ces consommateurs avant de promettre un impact limité aux seuls nouveaux déploiements.
La recette réseau commence par le rôle des adresses
Après l’opération, contrôle les nouvelles VM et leurs adresses dans vCenter, le runtime enregistré et sa version, l’état des composants et la santé des services. Compare l’inventaire à ce que le plan annonçait, y compris les réserves d’adresses pour le cycle de vie.
Dans notre scénario Aria, les anciennes IP .21, .22 et .23 doivent être retrouvées dans leur rôle de VIP, pas forcément sur les cartes des nouvelles VM. Les nœuds utilisent le nouveau pool .81 à .85, et l’endpoint du runtime .90 reste distinct. Pour une source 9.0.x, la recette attend le comportement différent prévu dans l’épisode 1. Un exemple Aria ne doit pas devenir un critère d’échec pour cette autre route.
Depuis un poste consommateur et les chemins d’intégration pertinents, vérifie A/PTR, TLS avec validation de la chaîne, nom historique d’Automation et chemin du load balancer. Compare les empreintes et SAN attendus, sans interpréter une différence non expliquée comme automatiquement acceptable. La conservation du certificat source n’implique pas que toutes les CA d’intégration ont été transférées.
Un conflit d’IP ou une mauvaise résolution n’est pas à contourner par une modification improvisée du DNS. Avant de changer, demande : qui répond maintenant à cette adresse ? Est-ce l’ancienne source, la nouvelle VIP, un autre équipement ou une entrée DNS incorrecte ? La KB 445657 illustre les contrôles de VIP déjà occupées. Si une tentative précédente a laissé des ressources, traite cet état selon la procédure adaptée ; ne réutilise pas aveuglément le même pool.
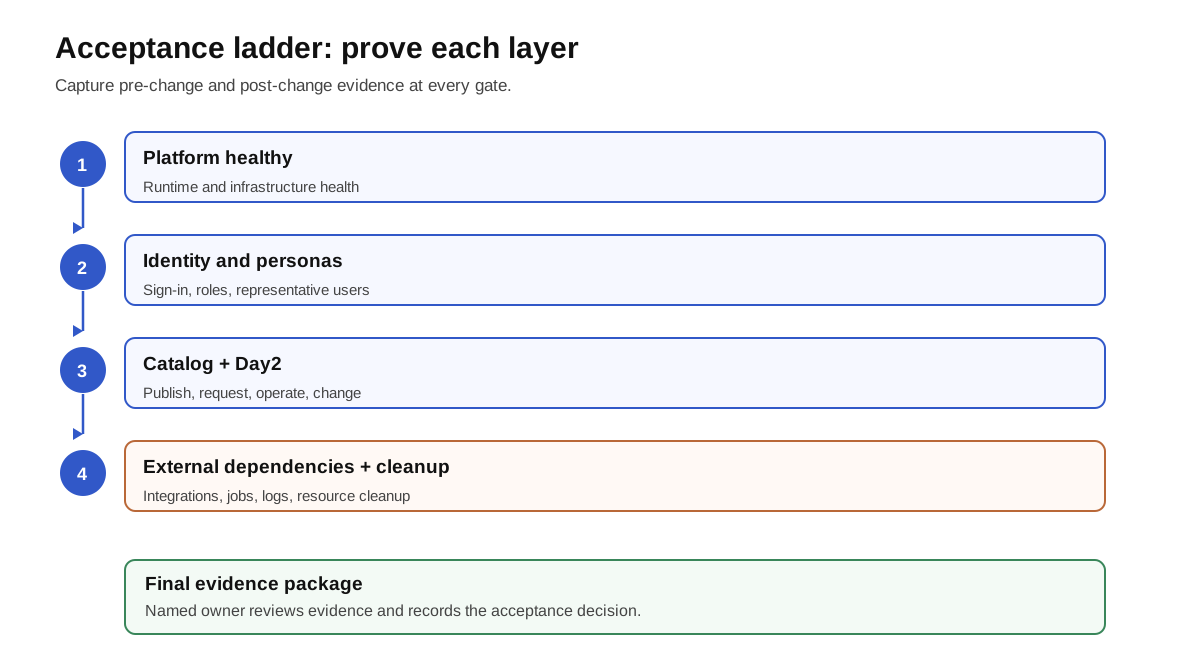
Une matrice avant/après qui exerce le vrai service
Chaque ligne reprend le même objet ou le même scénario que la référence avant migration. Les résultats attendus sont ceux de notre contrat de service, pas seulement une couleur verte dans la console.
| Périmètre | Vérification après | Preuve attendue |
|---|---|---|
| Version et orchestration | Builds Automation/runtime, tâche et inventaire Fleet | Couple supporté ; workflow terminé ou incident expliqué |
| Accès réseau | Nom historique, runtime distinct, VIP/LB et TLS | Résolution et endpoint attendus depuis les bons réseaux |
| Identité | Utilisateur habituel, compte de secours et rôles | Connexion réussie et permissions correctes, sans élévation inattendue |
| Intégrations | Validation de connexion et collecte des comptes cloud | Pas d’erreur de confiance, d’authentification ou de collecte |
| Catalogue | Demande du petit service témoin | Demande terminée avec paramètres et placement attendus |
| Existant | Action du jour 2 autorisée sur un déploiement témoin | Objet toujours géré, résultat comparable à la baseline |
| Extensibilité | Formulaire, souscription bloquante, workflow/ABX utilisés | Résultat métier observé, pas seulement workflow déclenché |
| Réseau du service | IPAM, DNS et règles nécessaires à la VM témoin | Réservations correctes ; service joignable selon son contrat |
| Nettoyage du témoin | Suppression du seul déploiement de test | Ressources et réservations libérées sans toucher aux autres |
| Cloud public, si utilisé | Statut native management et parcours applicable | Fonctionnalité réactivée si décidée, action et demande contrôlées |
| Sauvegarde de la cible | Nouveau job selon méthode supportée | Sauvegarde réussie, exploitable et associée à la nouvelle version |
Dans notre exemple, TOP commande une VM de test, vérifie son adresse et son enregistrement, exécute l’action réversible choisie avant la fenêtre, puis supprime cette VM de test. Il observe aussi le retrait de la réservation IP et de l’enregistrement DNS si le service le prévoit. Une VM supprimée dans vCenter avec une réservation IPAM orpheline n’est pas un service correctement nettoyé.
Pour l’extensibilité, vérifie les paramètres et les effets du workflow. Une souscription bloquante peut empêcher une demande d’aboutir alors que les pods et le portail semblent sains. La KB 454143 décrit un cas post-migration 9.1.0. Ne transforme pas son contournement en étape obligatoire pour tout 9.1.1 : commence par comparer la signature et le build.
Pour la gestion native du cloud public, l’état et la réactivation attendus sont ceux de l’épisode 2 et de la KB 448993. Laisse le temps aux synchronisations documentées avant de conclure sur un statut Stale. Ne modifie pas toutes les ressources pour accélérer artificiellement cette observation.
Si une preuve manque, choisir la bonne récupération
Voici nos critères de décision opérationnels. Ils ne promettent pas qu’une même restauration soit possible à n’importe quelle étape.
| État atteint | Réaction proposée |
|---|---|
| Préchecks en échec, source encore opérationnelle | Garder la source en service, corriger et replanifier ; pas de rollback à inventer |
| Services source arrêtés, export ou transfert en cours/échec | Conserver l’état et les journaux ; suivre la reprise ou restauration supportée pour cette étape |
| Cible démarrée, orchestration ou inventaire incomplet | Distinguer santé du produit et échec du workflow ; diagnostiquer avant toute relance concurrente |
| Cible active mais recette métier en échec | Maintenir le gel ; décider correction sur cible ou récupération coordonnée selon le délai et les données écrites |
| Nouvelles demandes déjà acceptées sur cible | Comptabiliser ces changements avant tout retour à une sauvegarde antérieure |
Collecte l’ID de tâche, les horaires, le build, l’erreur exacte et les journaux requis avant une intervention. Par exemple, la KB 441246 décrit une orchestration en timeout alors que le déploiement est opérationnel : ni « tout supprimer » ni « ignorer le rouge » n’est une conclusion suffisante.
Le retour arrière doit coordonner données, disques, réseau/VIP et inventaire lifecycle. Restaurer seulement une ancienne VM et laisser la cible active n’est pas ce plan. Utilise la procédure de sauvegarde/restauration et, si nécessaire, le support Broadcom pour l’état atteint. Les scripts de remédiation de KB ne sont à appliquer que lorsque leur version et leur signature correspondent ; nous ne reproduisons pas de script opaque à lancer au hasard.
Rouvrir, observer, puis retirer l’ancien
Lève le gel progressivement selon le plan local, observe les premières demandes, les collectes et les erreurs d’intégration. Surveille aussi l’espace disque, les services et les prochains jobs de sauvegarde. Fais confirmer la recette par les propriétaires des services ; le pilote de migration ne peut pas attester seul de tous les résultats métier.
Les anciennes VM et snapshots temporaires sont retirés après acceptation, période d’observation et validation de la stratégie de récupération. La durée de conservation dépend du plan local ; garder indéfiniment des snapshots n’est pas une sauvegarde. Ne supprime pas vIDM tant qu’il assure l’authentification. La migration vers Identity Broker et l’évolution vers All Apps gardent leurs propres dossiers.
TOP peut ranger les clés. Son critère final n’était pas « le bâtiment est neuf », mais « notre commande a retrouvé un trajet vérifié, et l’équipe sait comment l’exploiter ».
La suite sépare deux autres chantiers : quitter vIDM et retirer Aria Suite Lifecycle sans arrêter les services VM Apps, puis réécrire progressivement vers All Apps.
Sources et remerciements
Merci à Mohammed Aakhil pour son technical deep dive 8.18.1 → 9.1, ainsi qu’à Arun Nukula, Iyaz Khan et Owen Sheehy, qu’il remercie dans son billet. Son explication du transfert éclaire la migration ; les exigences 9.1.1 viennent de la documentation officielle et des KB liées. Scènes, schémas et matrice de recette sont nos propres supports pédagogiques.
Reçois le prochain par email
Les nouveaux articles et séries, envoyés à leur publication. Aucun autre courrier.