TOP arrive avec trois étiquettes et une idée rassurante : « On va remplacer l’enseigne Aria par VCF, puis redémarrer. » Sur le chantier, une nouvelle salle de contrôle l’attend. Son carnet d’adresses, lui, ressemble encore au plan de l’ancien bâtiment.
Le changement porte sur l’endroit où les services fonctionnent, leur cycle de vie et la fonction des adresses. Le nom que les utilisateurs connaissent peut rester identique alors que les machines derrière lui ont été remplacées. Avant de cliquer sur Upgrade, nous allons dessiner ce changement.
Cette série vise VCF Automation 9.1.1, avec les différences importantes entre builds. Elle s’appuie sur les sources consultées le 25 octobre 2026 ; ce n’est pas le compte rendu d’une migration exécutée dans notre laboratoire. Les exemples d’IP sont fictifs. TOP accompagne une migration de plateforme ; la transformation des services VM Apps vers All Apps constitue un autre chantier.
Le déménagement en trois questions
- Qui héberge quoi ?Distinguer les deux runtimes.
- Quelle adresse fait quoi ?Séparer nœuds, VIP et endpoint du runtime.
- Qu’est-ce qui se chevauche ?Vérifier les pools physiques et le réseau interne.
Deux salles techniques, pas un seul « management »
Le VCF Services Runtime est le socle qui héberge des services sous forme de conteneurs. Automation dispose de son instance dédiée, distincte de celle des VCF Management Services. Fleet Lifecycle organise les opérations depuis VCF Operations ; le runtime dédié héberge Automation. Le guide impose que leurs FQDN et pools d’adresses de nœuds soient distincts. Procédure officielle.
Dans une conversation, on peut appeler ces éléments « les management services d’Automation ». Dans le dossier technique, écrivons runtime dédié à Automation : cela évite de réserver les mêmes IP pour deux ensembles différents. Ce runtime n’est pas un runner CI/CD à installer pour lancer l’upgrade.
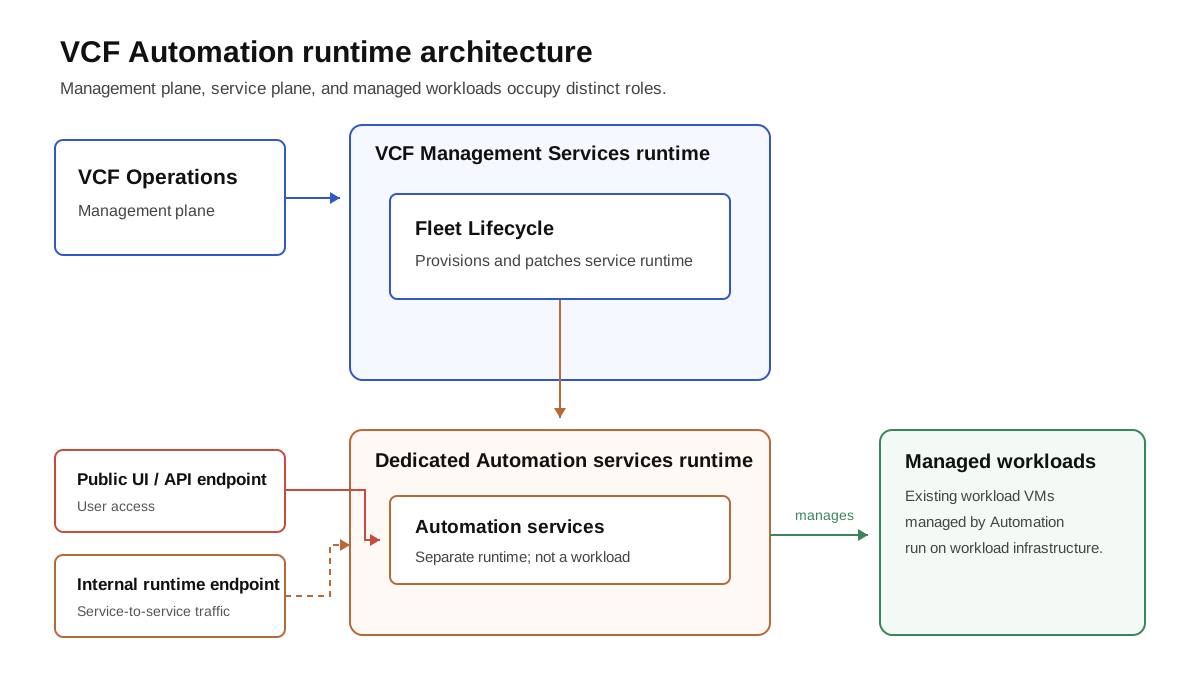
Vue logique : les boîtes représentent des responsabilités, pas un dimensionnement en VM. Le runtime Automation, le runtime Management Services et les clusters hébergeant les workloads sont trois périmètres à distinguer.
L’analogie de TOP est une centrale d’expédition : déplacer la salle qui reçoit les commandes ne déplace pas automatiquement les entrepôts déjà construits. Les VM et applications gérées ne sont pas toutes redéployées parce que la plateforme de contrôle change. En revanche, une intégration de provisioning cassée peut empêcher une nouvelle demande ou une action sur une VM existante. La recette devra donc tester les deux.
Même nom en façade, autre rôle pour les anciennes IP
La distinction la plus facile à manquer dépend de la source. Le guide décrit la conservation du FQDN public d’Automation et deux comportements différents :
| Source avant migration | Devenir des IP des anciens nœuds |
|---|---|
| Aria Automation 8.18.x | Reprises automatiquement comme VIP de la nouvelle instance |
| VCF Automation 9.0.x | Libérées après la mise à niveau |
Les nouveaux nœuds sont déployés sur le même réseau que les nœuds source. Avec un load balancer externe existant, le guide n’exige pas de changement de configuration du load balancer. Architecture de la migration.
Pour notre exemple Aria à trois nœuds, TOP possède 10.60.20.21, .22 et .23. Après migration, ces adresses deviennent des adresses virtuelles, tandis que les nouvelles VM utilisent le pool prévu pour leurs nœuds. Copier les anciennes IP dans les propriétés réseau des nouvelles VM serait une mauvaise traduction du mot « conserver ».
Une VIP est une adresse de service présentée par la plateforme. Ce n’est pas une quatrième ou une cinquième VM à créer à la main. Et FQDN public d’Automation, VIP du load balancer et IP du premier nœud ne sont pas des synonymes. Avec un load balancer interne, une erreur de Primary VIP est précisément documentée dans la KB 444108 : relever la topologie avant de renseigner le plan est indispensable.
Pourquoi demander de nouvelles adresses ?
Le nouveau runtime doit exister pendant la transition. Il faut aussi laisser une marge aux opérations futures. Le besoin documenté est cinq adresses de nœuds : trois affectées et deux réservées pour le remplacement de nœuds ou les rolling updates. Les premières cibles 9.1 demandaient un bloc /29 de huit adresses ; les versions plus récentes permettent cinq IP individuelles, selon les prérequis du parcours. La KB 448617 précise les composants Fleet/SDDC Lifecycle/runtime requis pour cette évolution.
TOP ne dessine donc pas « cinq machines obligatoires ». Il dessine trois allocations immédiates et deux possibilités de remplacement. Si toutes les places de secours deviennent des adresses de supervision ou des imprimantes, le premier déménagement réussira peut-être ; une opération ultérieure n’aura plus la marge attendue.
Le FQDN du runtime Automation doit résoudre vers une autre IP, hors du pool des nœuds. Il est distinct du FQDN utilisateur et sert aux échanges entre composants. La KB 443199 détaille cette séparation. Réutiliser le même nom pour runtime et Automation peut casser la synchronisation d’inventaire après l’upgrade : KB 457537.
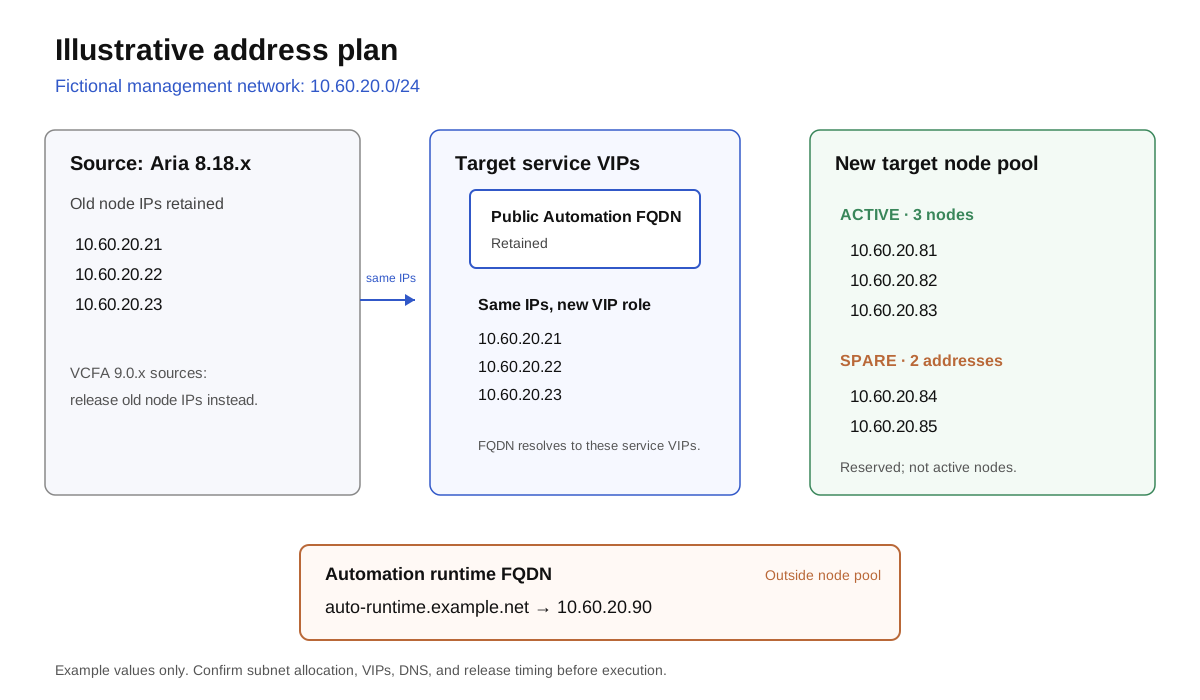
Exemple pédagogique sur un réseau de management fictif 10.60.20.0/24. Il ne constitue ni une configuration d’appliance à copier, ni une allocation proposée pour ton réseau.
| Objet de notre exemple | Réservation proposée dans l’IPAM | Contrôle |
|---|---|---|
| Anciennes IP Aria | .21, .22, .23 |
Conservées pour la reprise en VIP ; pas réattribuées ailleurs |
| Pool des nouveaux nœuds | .81 à .85 |
Cinq adresses disponibles sur le réseau source |
| Runtime Automation | auto-runtime.example.net → .90 |
A/PTR cohérents ; hors du pool |
| Accès utilisateurs | Nom Automation existant | Résolution, certificat et chemin LB relevés avant/après |
| Runtime Management Services | Allocation séparée, non dessinée ici | Pas de réutilisation du pool ou du nom Automation |
Un CIDR n’est pas nécessairement un nouveau VLAN
10.60.20.80/29 désigne un bloc aligné de huit valeurs, .80 à .87. Ce n’est pas équivalent à écrire « huit IP à partir de .81 ». Dans l’exemple précédent, nous avons choisi cinq IP individuelles ; nous n’avons pas déclaré ce bloc /29 à l’assistant.
Un CIDR utilisé comme allocation dans un réseau existant n’implique pas que l’on configure un nouveau masque /29 sur les interfaces, une nouvelle passerelle ou un nouveau VLAN. Si l’on créait réellement un sous-réseau IPv4 /29, il faudrait aussi tenir compte des adresses réseau et broadcast. Le formulaire d’un produit et le plan de routage répondent à deux questions différentes. La KB 445718 décrit l’ancienne contrainte des huit adresses contiguës sur le réseau de management.
Il existe en plus un CIDR interne au runtime, par défaut 198.18.0.0/15. Ce réseau interne ne remplace pas le pool d’IP de management. Broadcom documente les alternatives 240.0.0.0/15 et 250.0.0.0/15 en cas de conflit et autorise deux runtimes isolés à utiliser le même réseau interne ; ce n’est pas une autorisation de leur donner les mêmes IP de management. Paramètres du réseau interne.
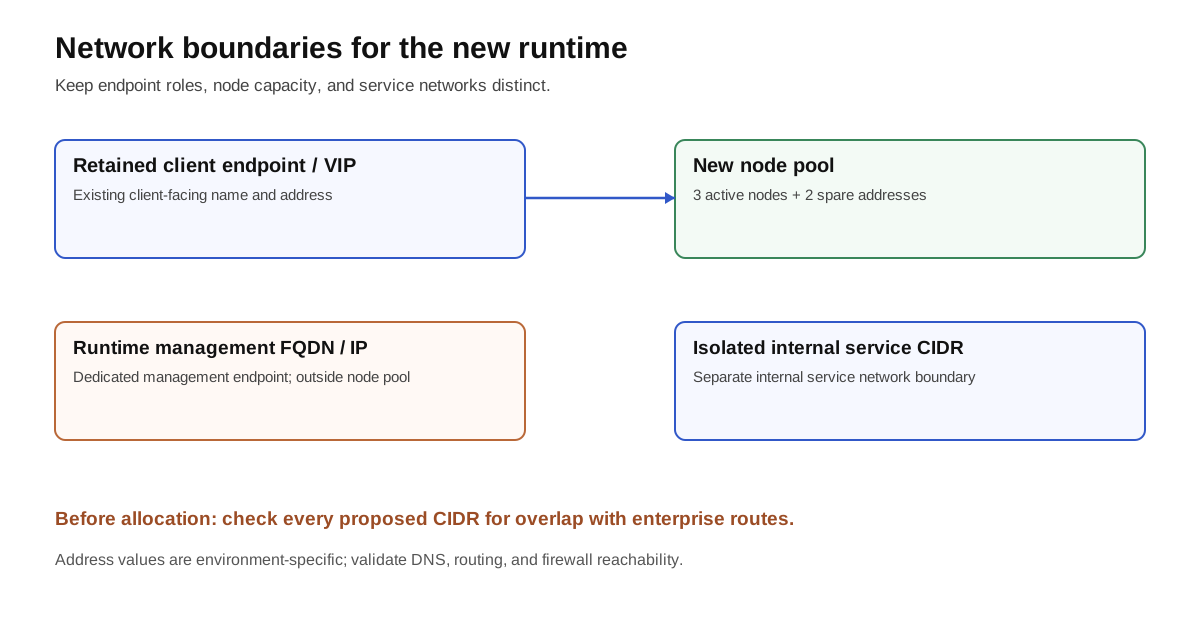
La continuité du point d’entrée ne dispense pas de réserver les nouvelles adresses et de vérifier les chevauchements du CIDR interne.
Les certificats pendant le déménagement
TOP conserve l’enseigne à l’entrée, puis découvre que la nouvelle salle de contrôle distribue ses propres badges de service. Il faut distinguer deux cycles de vie de certificats.
Le workflow Aria Automation 8.18 → VCF Automation 9.1.x conserve et réutilise le certificat existant d’Aria, y compris s’il est signé par une autorité de certification (CA) interne ou publique. Le changement de nom du produit n’impose pas de remplacer un certificat conforme. Avant l’upgrade, vérifie l’échéance et les SAN exigés : FQDN/IP de chaque nœud Automation et du LB/de la VIP. Pour un certificat non conforme, utilise la procédure de remplacement du produit source. Guide de mise à niveau.
Pour les certificats internes des services du Service Runtime, la plateforme gère automatiquement leur émission et leur renouvellement avec cert-manager. Dans le déploiement normal, tu n’as pas à fabriquer manuellement un certificat ni à copier la clé privée d’Aria dans chaque service interne. Broadcom décrit cette rotation automatique pour les services d’Automation et ceux du cycle de vie du runtime. KB 450789, KB 448618.
| Certificat ou relation de confiance | Effet de l’upgrade | Vérification de l’opérateur |
|---|---|---|
| Accès historique à Automation | Réutilisation du certificat Aria pour la migration décrite ci-dessus | SAN attendus, émetteur, échéance et certificat réellement présenté sur le chemin LB/TLS |
| Services internes du runtime dédié | Émission et renouvellement gérés par la plateforme via cert-manager |
État des certificats, échéances/renouvellements et communications entre services |
| Confiance envers vCenter, NSX et autres intégrations externes | Sujet distinct de la conservation du certificat d’accès | Enregistrement explicite des certificats d’endpoints et connexions validées |
Un certificat d’ingress personnalisé du runtime reste une configuration distincte, associée au FQDN de ce runtime. L’émission interne automatique ne signifie ni que ton certificat historique couvre ce nouveau nom, ni que cert-manager renouvelle le certificat d’accès conservé signé par ta CA, ni que toute CA privée est approuvée partout. Si tu personnalises un certificat présenté, vérifie aussi sa chaîne de confiance ; la KB 420053 illustre le besoin de l’intégrer au bundle de confiance de la plateforme pour les intégrations VKS.
Le piège moins visible concerne la confiance sortante. Un endpoint Aria peut fonctionner grâce à une confiance implicite envers une CA commune ou publique sans que son certificat soit enregistré dans la base de provisioning. Ce magasin de confiance n’est pas migré. Applique la KB 425489 à la source concernée, avec sa sauvegarde préalable, puis relance le précheck des certificats d’endpoints. Conserver le certificat du navigateur ne prouve pas que les connexions vCenter ou NSX resteront approuvées.
Complément certificats et sources associées vérifiés le 26 octobre 2026 ; la date de recherche du reste de l’article indiquée plus haut est conservée.
À toi de vérifier : un carnet qui prouve ses réponses
Avant la fenêtre, renseigne pour chaque objet : IP, FQDN, fonction, propriétaire, source de réservation et devenir après migration. Fais relire ce tableau par les équipes réseau et plateforme. Un ping silencieux ne prouve pas qu’une adresse est libre : vérifie aussi l’IPAM, les réservations et les équipements non actifs.
Depuis un poste d’administration et depuis les chemins utilisés par les composants, relève les résolutions avant/après. Ces commandes ne modifient rien ; adapte les noms fictifs :
dig +short auto-runtime.example.net A
dig +short -x 10.60.20.90
openssl s_client -connect automation.example.net:443 \
  -servername automation.example.net -verify_hostname automation.example.net \
  -verify_return_error </dev/null
La réponse A doit correspondre à la réservation ; le PTR doit renvoyer le nom prévu. -servername transmet le nom du serveur TLS ; -verify_hostname contrôle aussi cette identité. Avec une CA privée, ajoute -CAfile organisation-ca-bundle.pem et le bundle de CA approuvé ; conserve -verify_return_error pour que le test échoue en cas de validation incorrecte. Vérifie la chaîne, les SAN et l’échéance avec le bon magasin de confiance. Options OpenSSL.
Avant la fenêtre, conserve sujet/SAN, émetteur, numéro de série, empreinte SHA-256, échéance et chaîne du certificat présenté, puis relève où TLS se termine. Après, refais le contrôle par le nom historique d’Automation et compare avec le certificat conservé attendu ou un remplacement documenté. Teste séparément l’endpoint du runtime et valide les intégrations vCenter/NSX réellement utilisées, la synchronisation d’inventaire et une demande de service représentative.
Pour l’opérateur disposant de l’accès d’administration pris en charge et du contexte Kubernetes du runtime dédié à Automation, cette commande vérifie en lecture seule deux certificats internes documentés par la KB 450789 :
kubectl -n prelude get certificate services-internal tenant-managerContrôle leur état Ready et consulte les échéances/renouvellements si nécessaire. Un certificat nouvellement émis ne prouve pas que tous les services consommateurs l’utilisent : la recette doit aussi couvrir leur santé et les connexions TLS réelles. Une connexion HTTPS qui réussit depuis ton portable ne démontre pas que le runtime peut joindre un IPAM, un annuaire ou un vCenter.
Avant : conserver le tableau, les règles réseau et le certificat observé. Après : contrôler les nouvelles IP de VM, les VIP attendues, l’accès par le nom historique et la disponibilité des deux adresses réservées. Ne remets pas sous tension les anciens nœuds pour « tester » les mêmes IP. Cela peut créer un conflit avec les VIP de la cible.
La suite : choisir le parcours et préparer les préchecks, puis suivre la bascule et la recette.
Sources et remerciements
Merci à Mohammed Aakhil pour son technical deep dive Aria 8.18.1 → VCF Automation 9.1, ainsi qu’aux contributeurs qu’il remercie : Arun Nukula, Iyaz Khan et Owen Sheehy. Il a inspiré le sujet ; son périmètre 9.1 ne suffit pas à valider chaque prérequis 9.1.1. Les liens TechDocs et KB au fil de l’article fondent les distinctions de version. Les scènes de TOP, schémas et exemples sont originaux.
Reçois le prochain par email
Les nouveaux articles et séries, envoyés à leur publication. Aucun autre courrier.